Das Bereinigen einer Microsoft-Office-Datei bedeutet, Dutzende von Schutzmaßnahmen darauf anzuwenden. Beim herkömmlichen Ansatz wird bei jeder Schutzmaßnahme das Dokument vollständig eingelesen, und jedes Mal, wenn eine Schutzmaßnahme angewendet wird, wird dasselbe Dokument erneut eingelesen.
Deep CDR™-Technologie liest jedes Dokument einmal ein und führt alle Bearbeitungsschritte in diesem einzigen Durchlauf durch. Diese Methode verkürzt die Verarbeitungszeit großer Office-Dateien um das Doppelte, wobei die Ergebnisse der Datenbereinigung unverändert bleiben.
Die versteckte Steuer der Gründlichkeit
Die Bereinigung ist von Grund auf gründlich konzipiert. Die Deep CDR™-Technologie bereinigt ein Microsoft Office-Dokument, indem sie Dutzende von Bereinigungsschritten gleichzeitig durchführt: externe Links, eingebettete Objekte, Bilder und deren Metadaten, Smart Tags und vieles mehr. Jeder Bereinigungsschritt zielt auf eine bestimmte Bedrohungskategorie ab und führt eine eigene Analyse sowie Bearbeitung durch.
Bei modernen Office-Dateien ist diese gründliche Überprüfung zeitaufwendig und ressourcenintensiv. Eine Word- oder Excel-Datei ist ein komprimierter Ordner. Darin befinden sich Textdateien, die in XML, einem strukturierten Format, das jede Zelle, jeden Absatz, jedes Bild und jeden Link im Dokument beschreibt. Um die Datei zu bereinigen, muss die Deep CDR™-Technologie dieses XML durchlesen. Eine Tabellenkalkulation, die als 50-MB-Datei eintrifft, kann sich beim Entpacken als ein einziges Arbeitsblatt mit einem halben Gigabyte XML entpuppen.
Bei einer herkömmlichen Motorarchitektur durchläuft jeder Verarbeitungsschritt das gesamte XML-Paket: ein Durchlauf für Links, ein weiterer für eingebettete Objekte, ein weiterer für Bilder und so weiter.
Die Verarbeitungskosten steigen mit jeder zusätzlich eingesetzten Schutzmaßnahme. Diese „versteckte Steuer“ äußert sich in längeren Dateiwarteschlangen und einem höheren Rechenaufwand bei gleichem Datenverkehr. Außerdem entsteht dadurch der Druck, Abstriche bei den Schutzmaßnahmen zu machen, nur um Schritt zu halten.
Ein-Durchgang-Strategie: Ein Walk, mehrere Arbeiter
Stellen Sie sich eine Hausbegehung vor. Normalerweise begutachten der Elektriker, der Klempner und der Brandschutzbeauftragte das Haus nacheinander, und jeder von ihnen geht alle Räume durch. Wie wäre es, wenn man sie alle gemeinsam hinschicken würde? Das Haus wird dann einmalig von allen erforderlichen Fachleuten begutachtet.
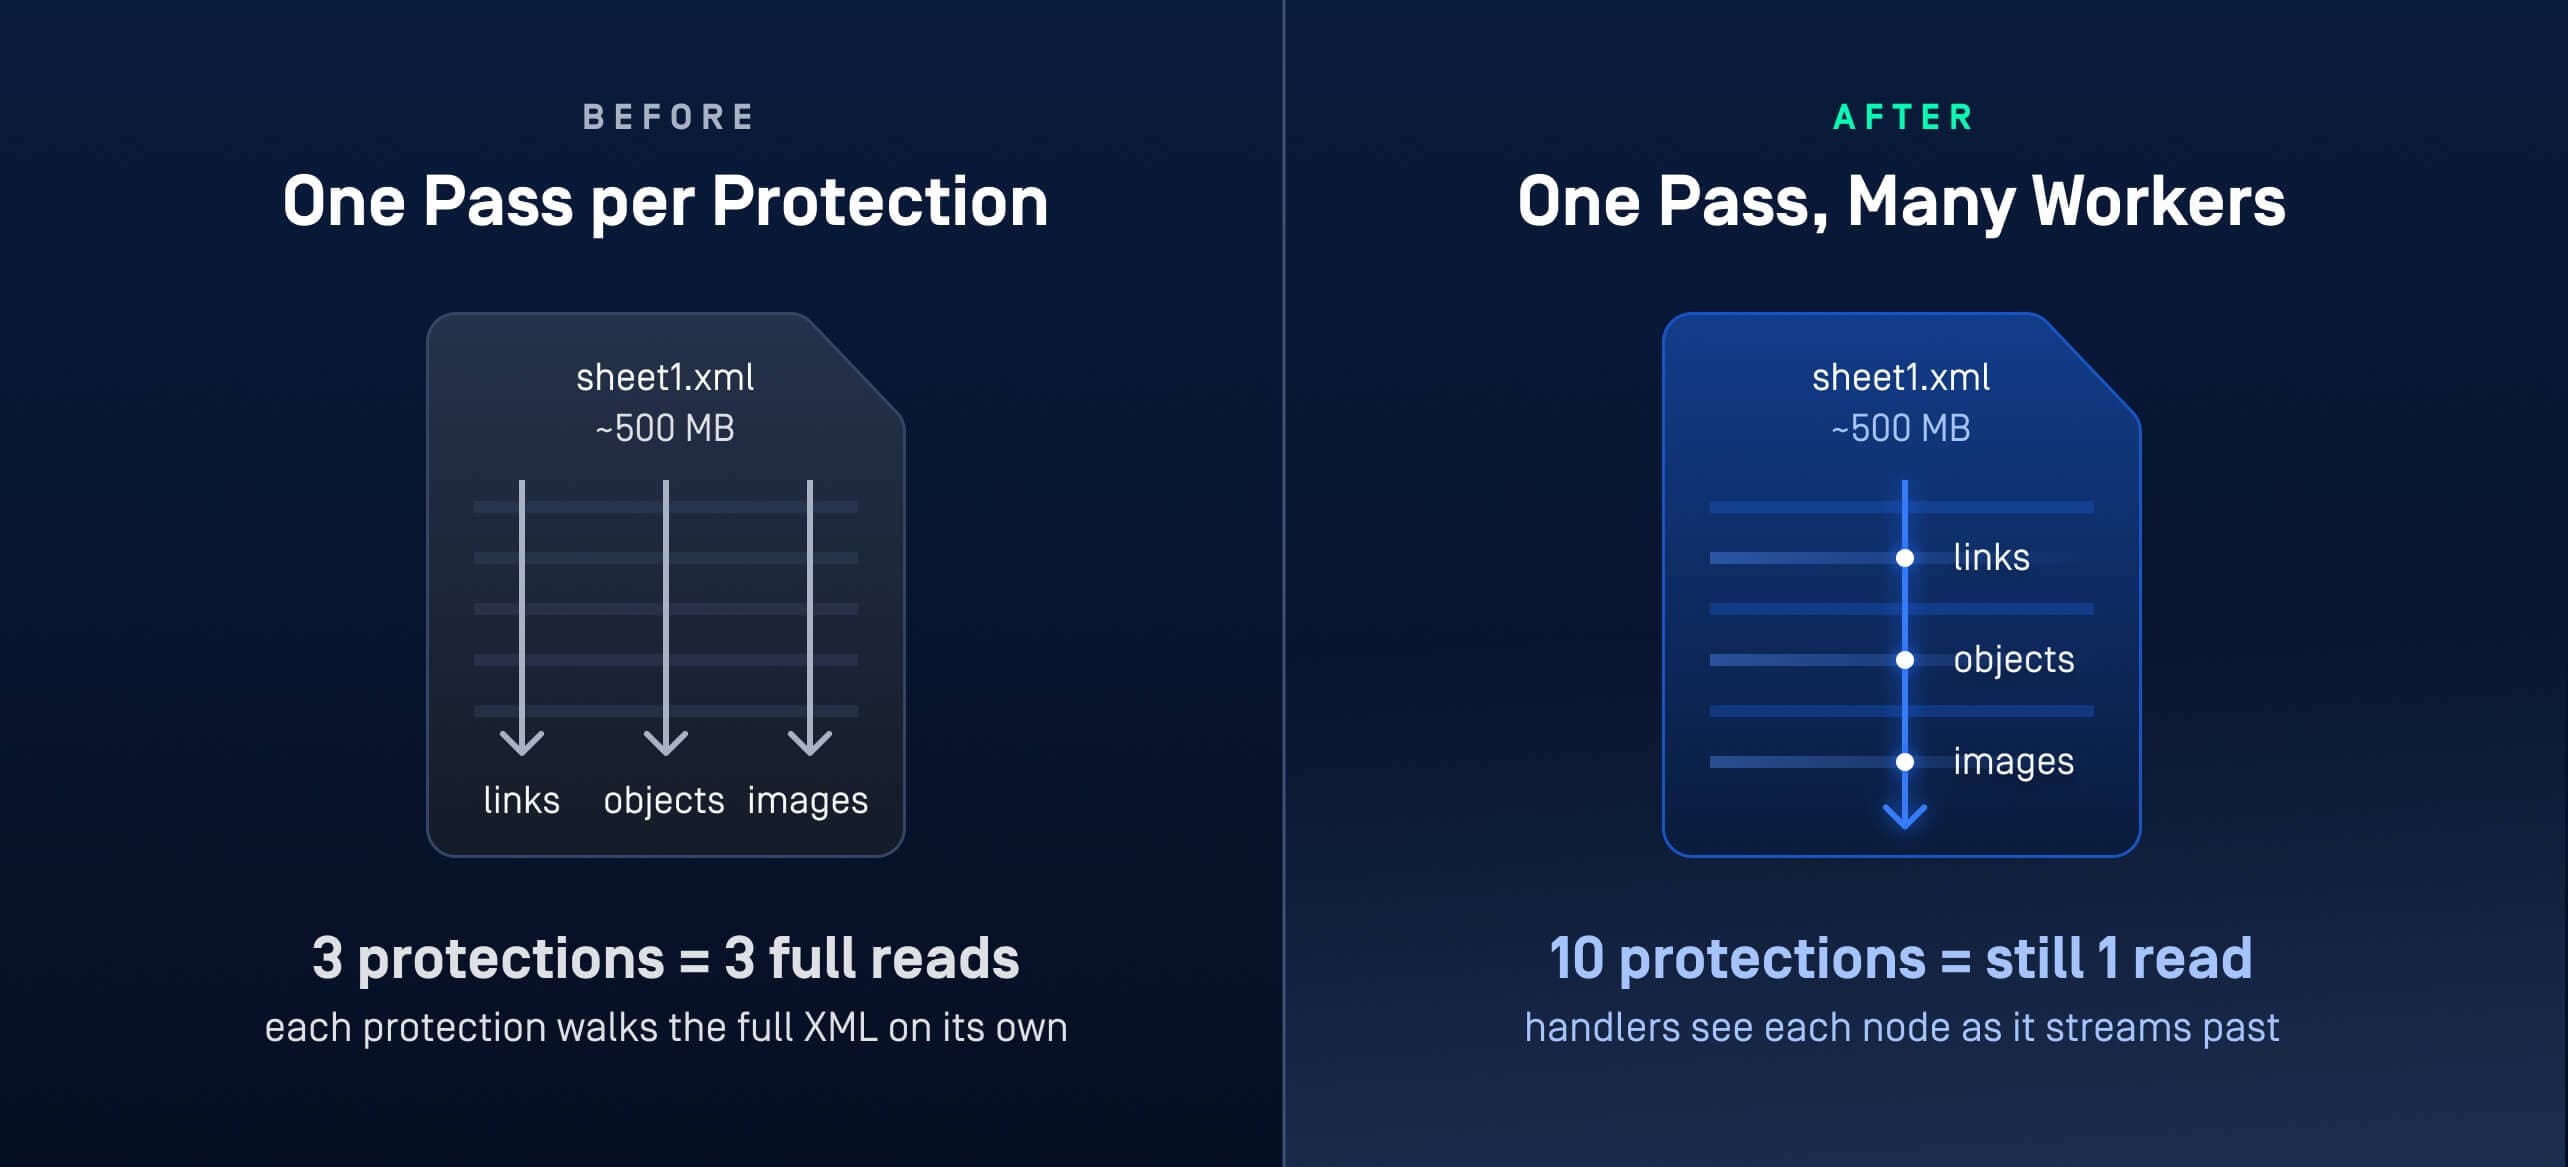
Genau das leistet die Ein-Durchlauf-Strategie der Deep CDR™-Technologie. Sie kehrt das herkömmliche Bereinigungsschema mit drei Konzepten um:
- Ein Host, ein Durchlauf. Ein einzelner Verarbeitungshost liest jeden XML-Teil des Dokuments genau einmal durch oder „durchläuft“ ihn. Jeder Schutzmechanismus ist ein Handler, der diesen Durchlauf begleitet, jeden vorbeiströmenden XML-Knoten erkennt und seine Aufgabe sofort ausführt. Zehn Schutzmechanismen bedeuten einen Durchlauf einer 500-MB-Datei, bei dem zehn Worker diese überwachen.
- Jeder Schutzmechanismus ist ein Plug-in. Ein spezialisierter Prüfer, auch „Handler“ genannt, ist durchgängig für einen bestimmten Bereich zuständig: die Verwendungsknoten innerhalb des XML-Inhalts, die Ressourcendefinitionen, die diese deklarieren, und das gespeicherte Artefakt selbst. Jeder Handler durchläuft denselben Lebenszyklus: Initialisierung, Verarbeitung jedes Knotens, Abschluss. Das Hinzufügen eines Schutzmechanismus zur Engine bedeutet, einen weiteren Handler für denselben Durchlauf zu registrieren. Der Aufwand für die Gründlichkeit steigt nicht mehr mit jedem hinzugefügten Schutzmechanismus.
- Deaktivierte Schutzmaßnahmen werden niemals ausgeführt. Bevor der Durchlauf beginnt, prüft jeder Handler, ob seine Konfiguration zutrifft. Ein Schutzmechanismus, der in Ihrer Richtlinie deaktiviert wurde, wird von vornherein übersprungen und verursacht keinen zusätzlichen Aufwand pro Knoten. Das Dokument wird einmal gelesen, und nur die relevanten Schutzmechanismen werden ausgeführt.
Was die Benchmarks zeigen
Wir haben die Strategie sowohl vor als auch nach der Umsetzung getestet – sowohl an speziell erstellten umfangreichen Dokumenten als auch an vollständigen Regressions-Testsuiten aus der Praxis, und zwar unter Windows und Linux.
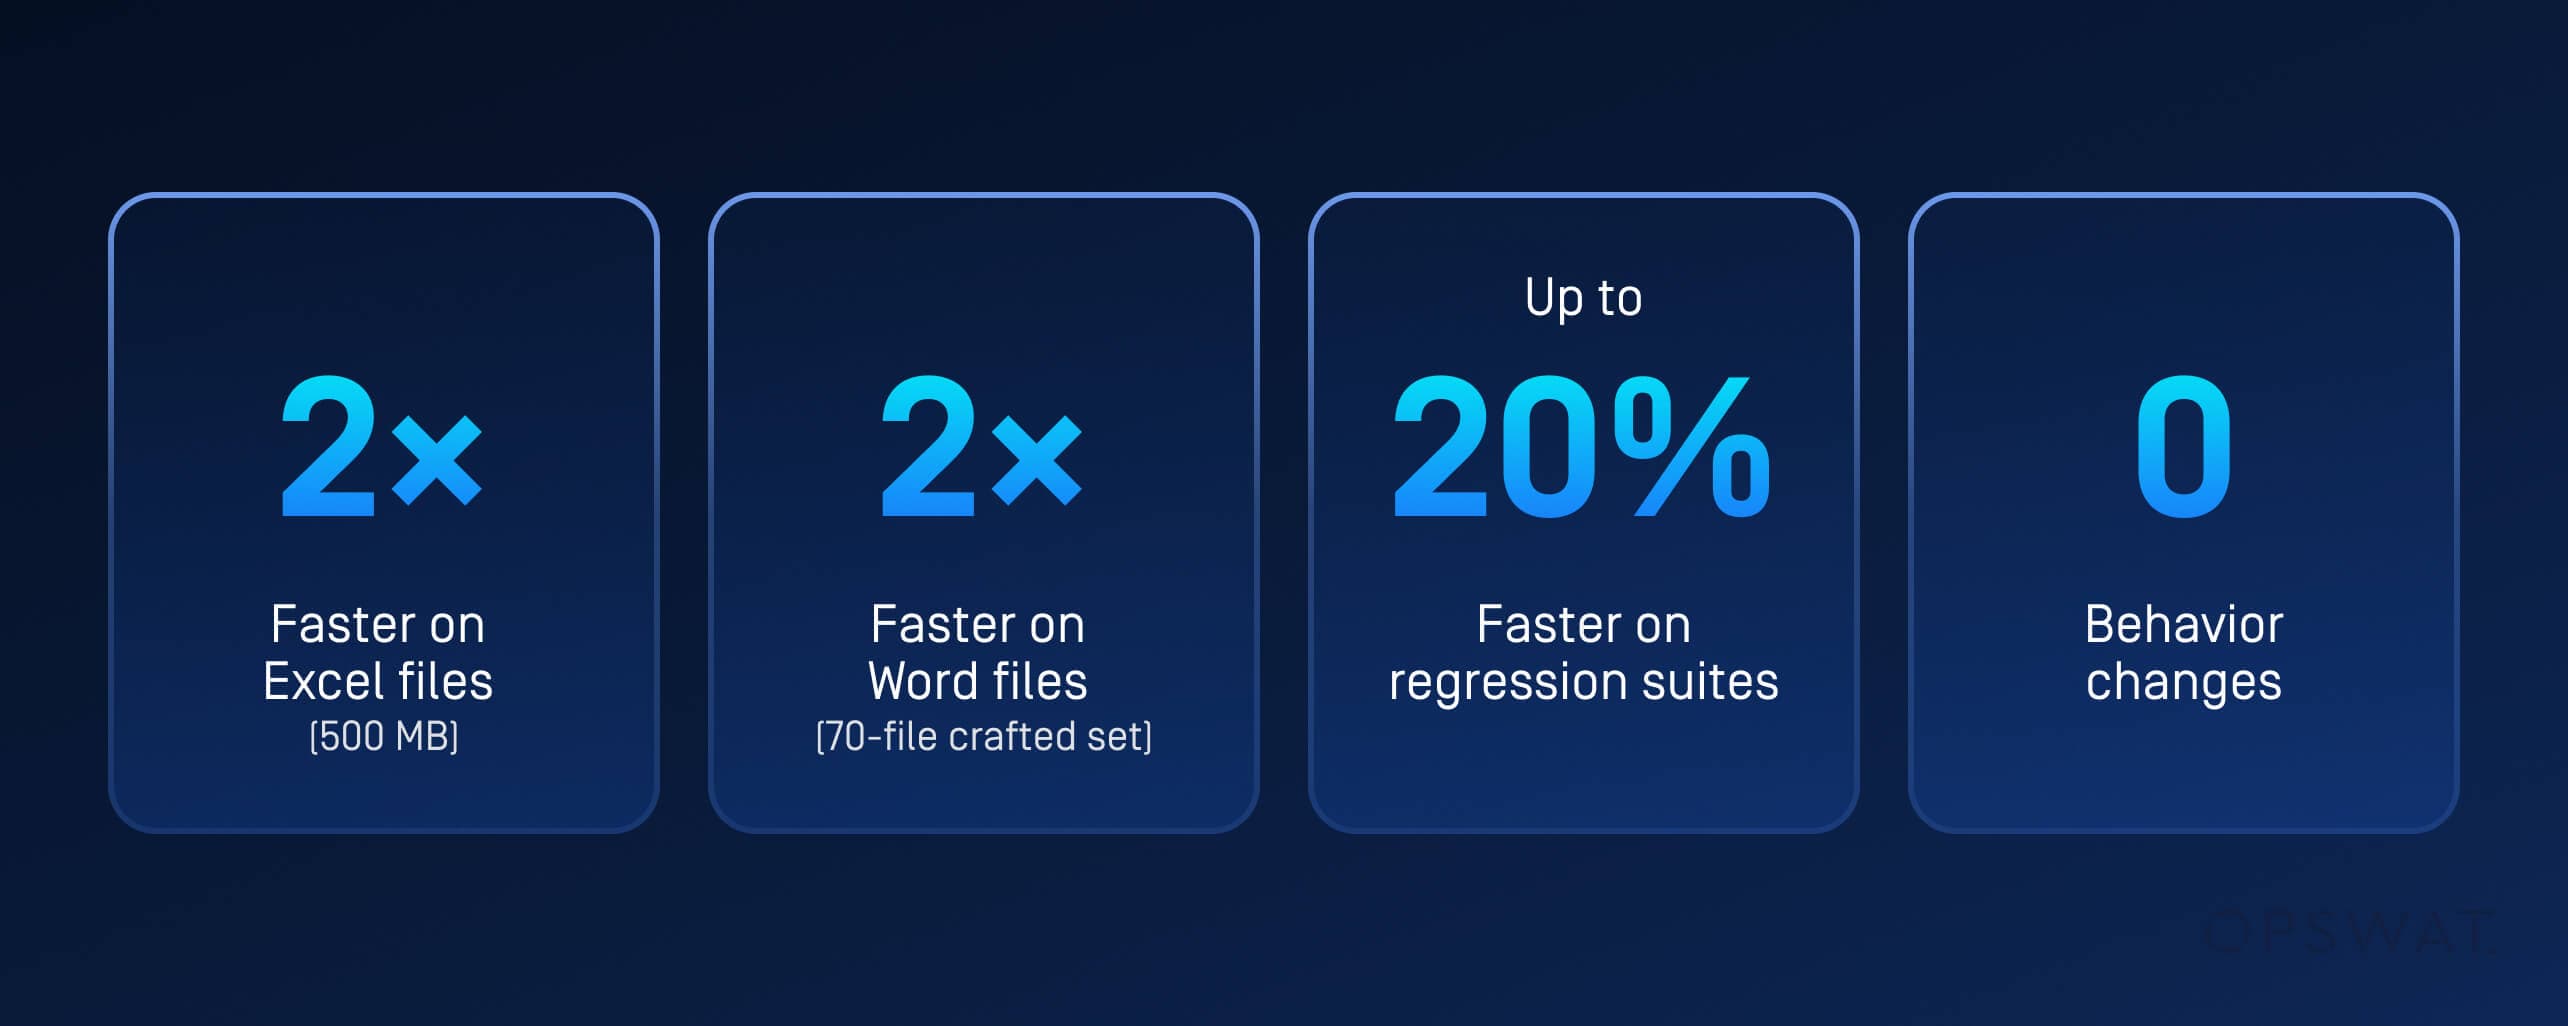
- Große Excel-Dokumente (ca. 500 MB an Arbeitsblatt-XML): etwa doppelt so schnell. Die Gesamtverarbeitungszeit verbesserte sich unter Windows um 94 % und unter Linux um 67 %, und bei der Datei mit dem höchsten Datendichte pro Arbeitsblatt betrug die Verbesserung 147 %.
- Große Word-Dokumente (Satz aus 70 speziell erstellten Dateien): Die Gesamtlaufzeit ist etwa doppelt so schnell, wobei sich die durchschnittliche Laufzeit pro Datei um 169 % verbessert hat.
- Regressionssuiten aus der Praxis (Tausende von Word-, Excel- und PowerPoint-Dateien): je nach Format und Plattform etwa 4 % bis 20 % schneller. Da die meisten Dateien klein sind, nimmt der Vorteil des einmaligen Lesens mit der Dokumentgröße zu.
- Keine Verhaltensänderung: Beide Versionen durchliefen die gesamten Regressionssuiten mit identischen Ergebnissen bei der Sanitisierung. Die Geschwindigkeitssteigerung wurde durch das Weglassen wiederholter Lesevorgänge erzielt, und es wurde kein Schutz übersprungen.
Dieses letzte Ergebnis ist am wichtigsten. Bei Sicherheitseinstellungen ist eine Leistungsangabe nur dann von Bedeutung, wenn der Schutz auf einem konstanten Niveau bleibt. Auch der Durchsatz an einem Gateway trägt zur Sicherheit bei: Je schneller eine Datei bereinigt wird, desto geringer ist der Druck auf die Teams, den Schutz zu umgehen.
Warum wir zuerst die Office-2007-Formate getestet haben
In der Office 2007-Produktfamilie (.docx, .xlsx und .pptx) konzentrieren sich die versteckten Kosten durch XML. Alle drei Formate weisen dieselbe Paketstruktur auf, sodass ein einziges Host-Design für alle ausreicht, und gerade bei datenblattintensivem Datenverkehr kommen in der Praxis XML-Teile mit einer Größe von einem halben Gigabyte vor.
Die Strategie selbst gilt für jedes Format, dessen Kosten in umfangreichen strukturierten Inhalten liegen, wodurch diese Formate für dieselbe Vorgehensweise in Frage kommen.
Früher hatte Gründlichkeit ihren Preis, der mit jeder zusätzlichen Schutzmaßnahme stieg. Bei der Ein-Durchlauf-Verarbeitung wertet die Deep CDR™-Technologie das gesamte Dokument nur einmal aus, unabhängig davon, wie viele Schutzmaßnahmen angewendet wurden.
Nhut Ngo ist Leiter der Abteilung „ Software Engineering“ bei OPSWAT, wo er die Entwicklerteams leitet, die hinter der Deep CDR™-Technologie und anderen Technologien zur Dateiverarbeitung in MetaDefender Core™ stehen. Mit mehr als einem Jahrzehnt Erfahrung in den Bereichen Softwareentwicklung und Cybersicherheit konzentriert er sich darauf, die Dateibereinigung schnell, präzise und für kritische Infrastrukturen einsatzbereit zu gestalten. Nhut promovierte 2015 in Informationswissenschaft.
