Im Juni 2025 gab Cisco die Sicherheitslücke CVE-2025-20282 bekannt, eine Schwachstelle mit höchster Schweregradstufe in seiner Identity Services Engine. Die Ursache war eine fehlende Dateivalidierungsprüfung beim Hochladen, wodurch ein nicht authentifizierter Angreifer eine manipulierte Datei in einem Verzeichnis mit erhöhten Rechten ablegen und diese als Root ausführen konnte. Der Fehler lag vor der Erkennung, nämlich in dem Schritt, in dem das System Daten akzeptierte, bevor eine Scan-Engine ausgeführt wurde.
Dieses Muster ist nicht auf ein bestimmtes Produkt beschränkt. Die Anzahl der Module in einem Stack stellt selten eine Einschränkung dar. Eine Datei muss erst analysiert werden, bevor sie ausgewertet werden kann, und moderne Formate verschachteln Inhalte auf eine Weise, die beim Parsen nicht immer erfasst wird.
Warum der Scan unauffällig war
Das signaturbasierte Scannen funktioniert durch den Abgleich von Bytes. Eine Engine verfügt über eine Datenbank mit Hashwerten und Byte-Mustern, die aus bekannter Malware stammen, und eine Datei muss übereinstimmende Bytes aufweisen, um erkannt zu werden. Bei verschachtelten Inhalten verhindern jedoch einige Faktoren, dass dies geschieht.
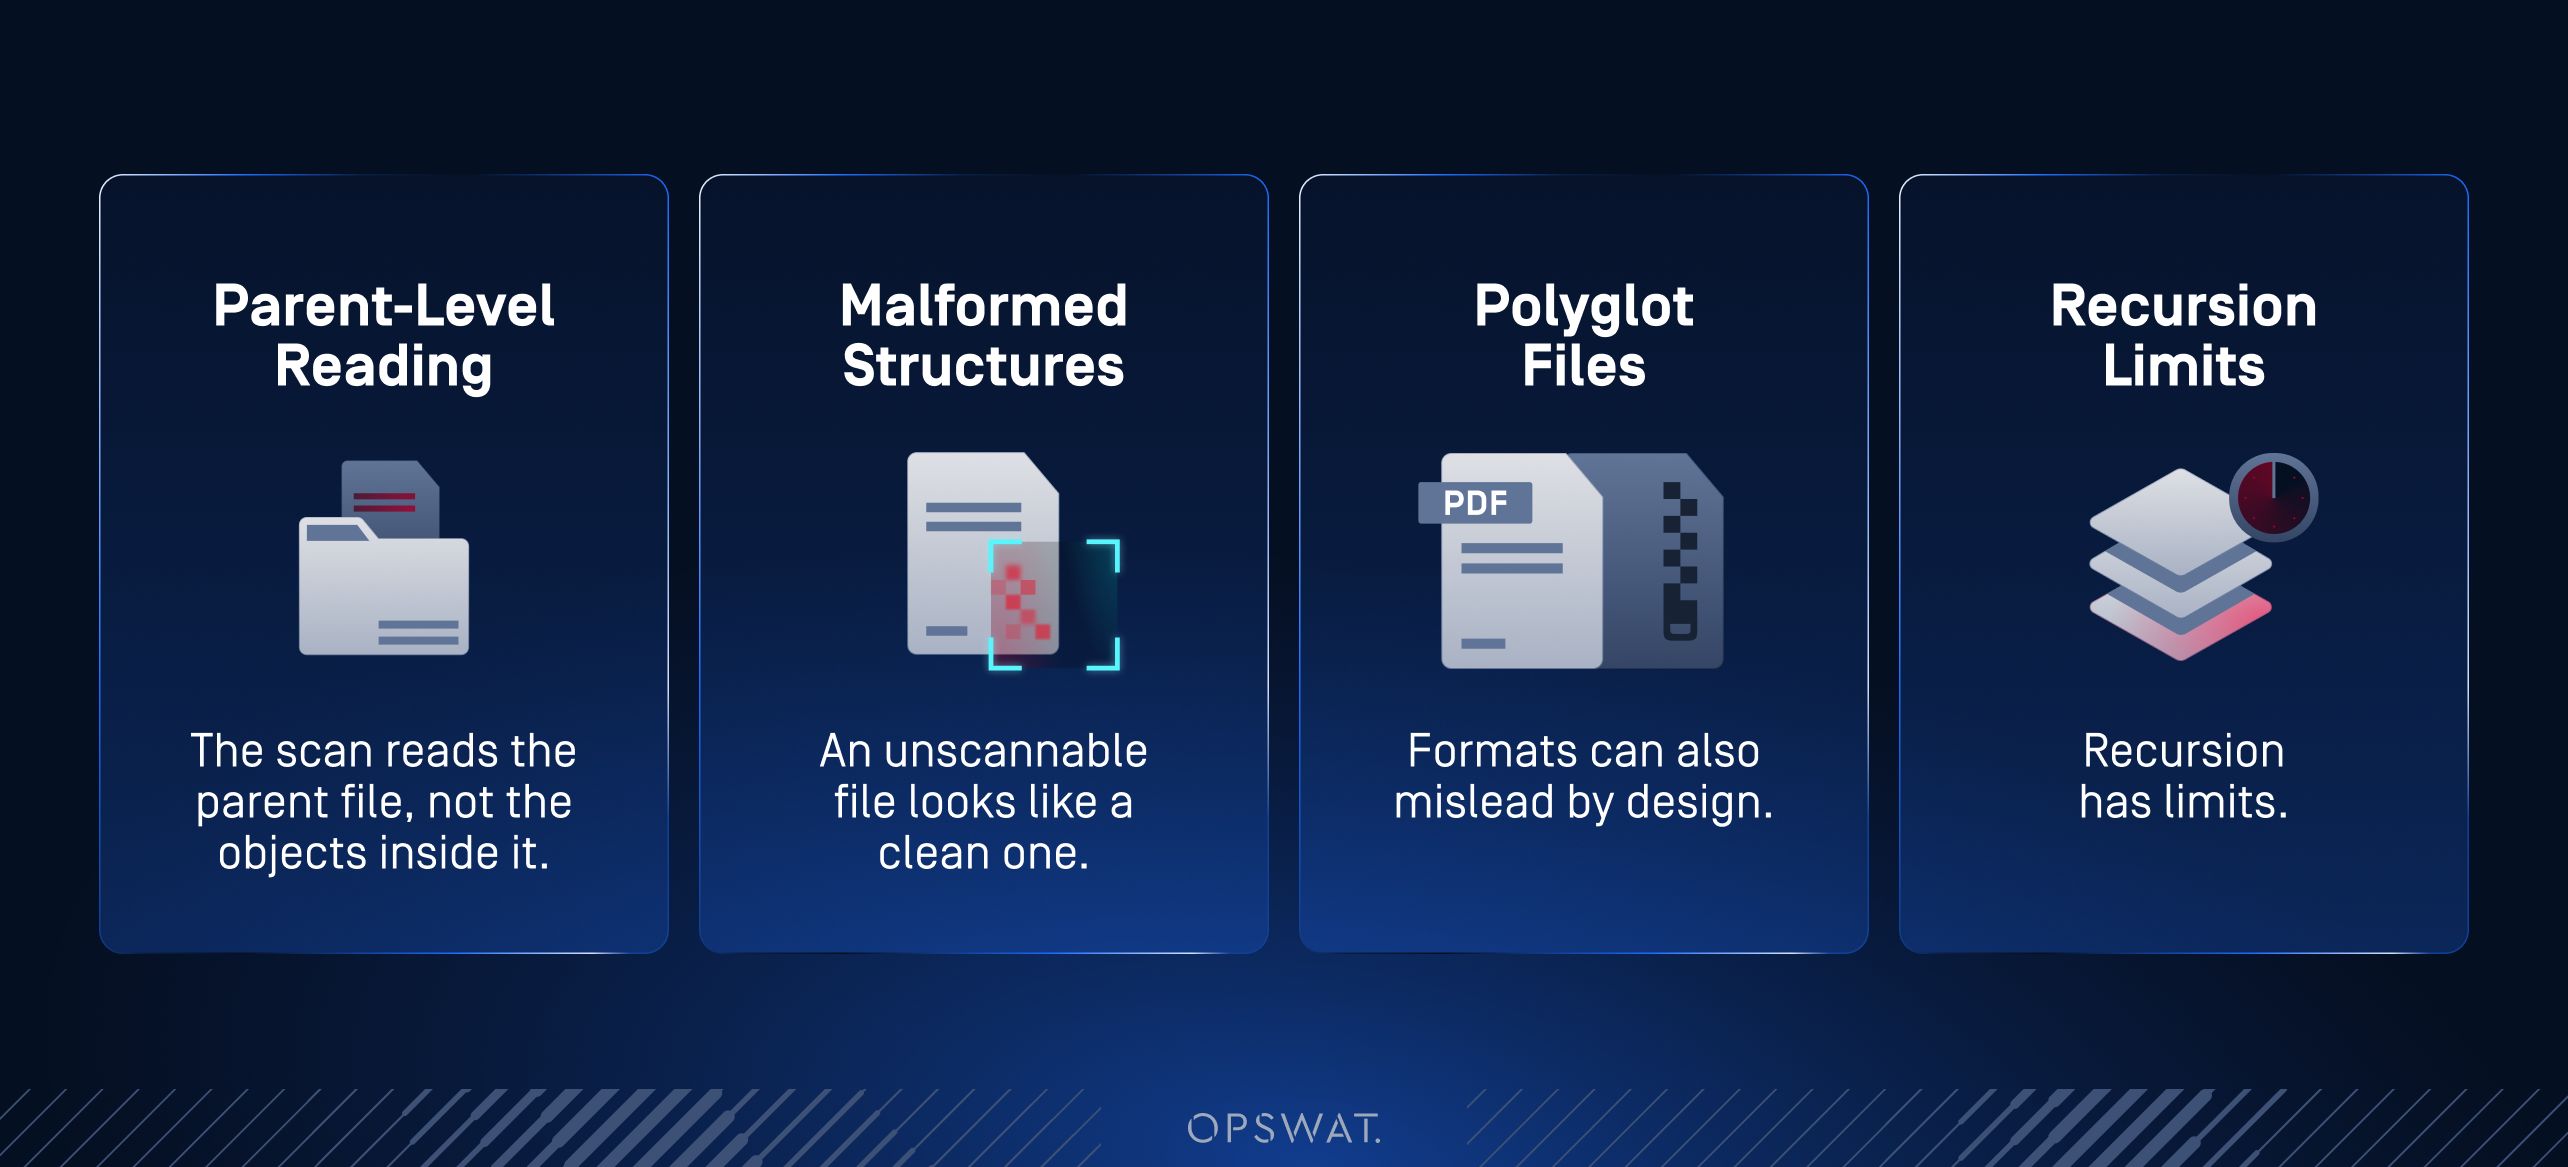
- Der Scan liest die übergeordnete Datei, nicht die darin enthaltenen Objekte. Ein Scan betrachtet die ihm vorgelegte Datei als ein einziges binäres Objekt und gleicht sie mit der Signaturdatenbank ab. Verschachtelte Inhalte werden in komprimierter oder verschlüsselter Form gespeichert, sodass eine ausführbare Datei, die sich in einem Dokumentstrom befindet, fast keine Byte-Sequenz mit derselben ausführbaren Datei auf der Festplatte gemeinsam hat. Das Muster, nach dem die Datenbank sucht, ist in der gespeicherten Datei nicht vorhanden und kann erst nach dem Entpacken des Datenstroms abgeglichen werden.
- Eine nicht scannbare Datei sieht aus wie eine einwandfreie. Eine fehlerhafte Struktur führt zu einem Abbruch der Analyse. Die Engine kann ihre Auswertung nicht abschließen, sodass die Datei übersprungen statt blockiert wird und ein Ergebnis mit der Bedeutung „konnte nicht ausgewertet werden“ an nachgelagerte Komponenten weitergeleitet wird, das nicht von einem Ergebnis mit der Bedeutung „nichts gefunden“ zu unterscheiden ist.
- Formate können auch bewusst irreführend gestaltet sein. Eine polyglotte Datei erfüllt zwei Formatspezifikationen gleichzeitig, sodass ein Parser sie als solche erkennt, während sich die Datei in Wirklichkeit ganz anders verhält.
- Rekursion hat ihre Grenzen. Verschachtelte Container unterliegen aus gutem Grund Tiefenbeschränkungen und Scan-Timeouts, da unbegrenzte Rekursion ein eigenes Denial-of-Service-Risiko darstellt. Eine Nutzlast, die unterhalb dieser Grenze platziert wird, wird niemals ausgewertet, und es ist weitaus weniger aufwendig, sie so tief zu platzieren, dass die Engine sie nicht erreichen kann, als sie zu umgehen.
Das Ergebnis ist ein Befund, der weniger aussagt, als es den Anschein hat. Ein „sauberes“ Ergebnis bedeutet, dass in dem Teil der Datei, den die Engine analysieren konnte, kein bekanntes Muster gefunden wurde. Es sagt nichts über die Bestandteile innerhalb der Datei aus und auch nichts über die Ebenen, die die Engine nie geöffnet hat.
Jede Schicht hat ihre Aufgabe. Eine fehlte.
Signaturbasiertes Scannen steht niemals für sich allein. Moderne Dateisicherheitslösungen sind oft bewusst mehrschichtig aufgebaut, und die umgebenden Schichten dienen dazu, die Lücken zu schließen, die der Musterabgleich nicht abdecken kann.
Bei der Dateityp-Identifizierung wird der tatsächliche Typ einer Datei anhand ihres Headers und nicht anhand ihrer angegebenen Dateiendung ermittelt. Dieses Verfahren ist von seiner Konzeption her schnell und oberflächlich und dient dazu, zu entscheiden, wohin eine Datei verschoben wird, und nicht, was sich in ihr befindet. Die dynamische Analyse beobachtet das Verhalten einer Datei in einer kontrollierten Umgebung. Sie ist das richtige Werkzeug für unbekannte Bedrohungen und am effektivsten, wenn sie selektiv und nicht auf jede einzelne Datei angewendet wird.
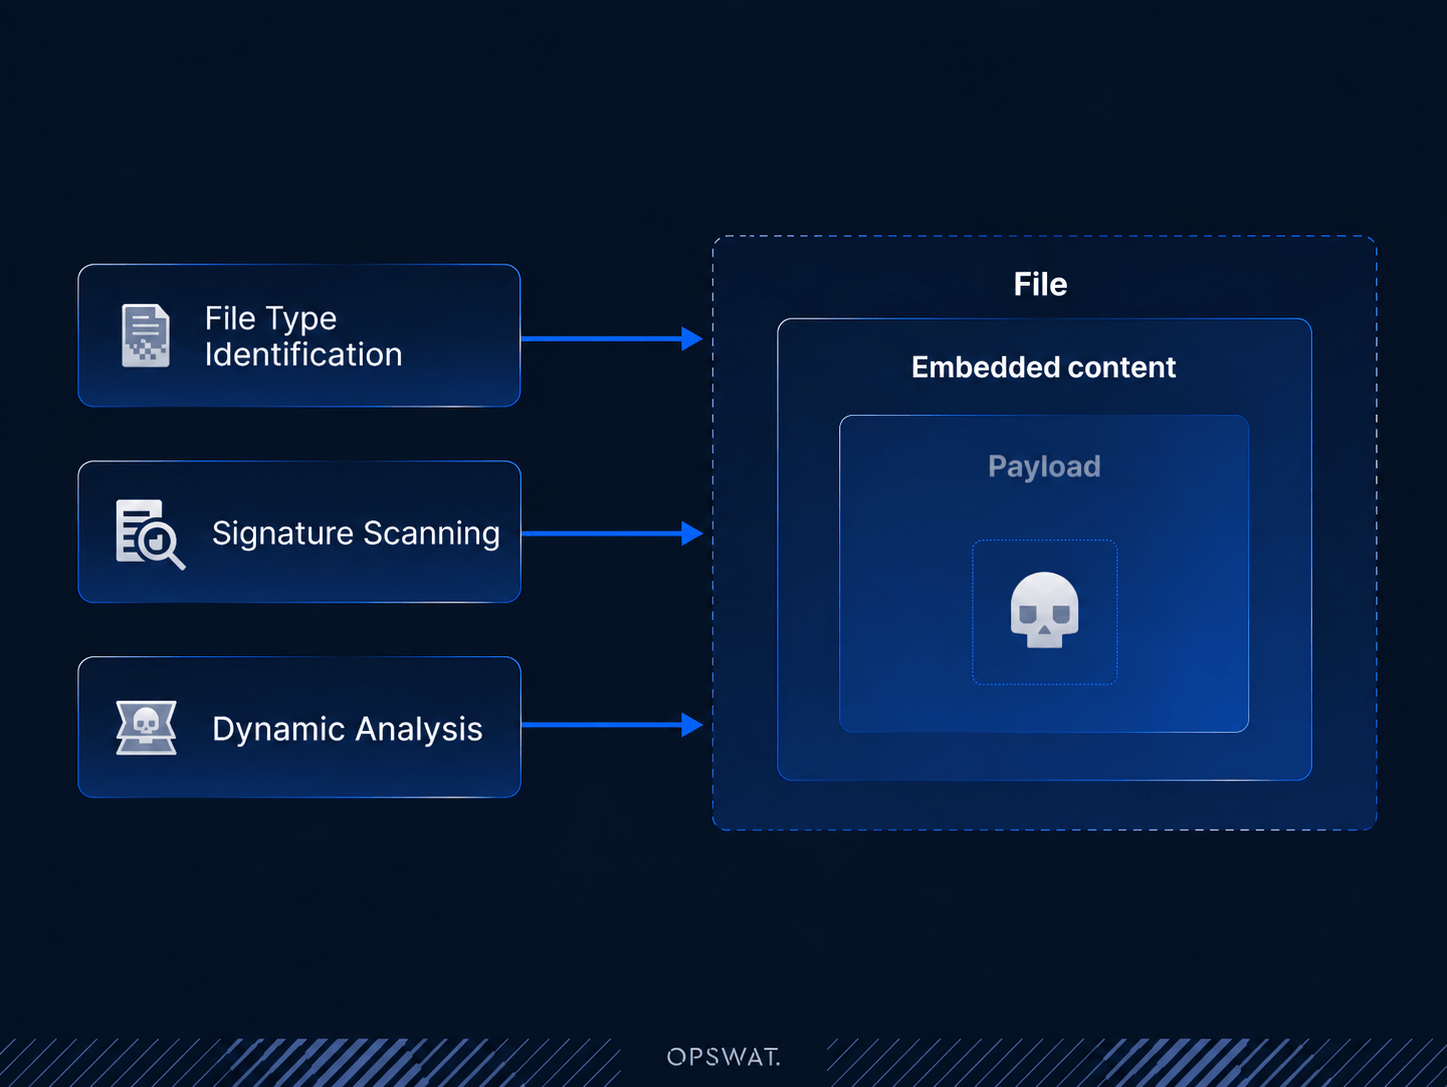
Jede Ebene erfüllt ihre Aufgabe, doch wenn eine Nutzlast niemals von der Datei getrennt wird, die sie enthält, oder unterhalb einer Tiefengrenze liegt, erreicht dieser Inhalt keine dieser Ebenen, sodass zusätzliche Ebenen hier keinen Ausgleich schaffen können. Der blinde Fleck reicht am weitesten bei Formaten, die überhaupt keinen Bereinigungspfad haben: Datenbankdateien, GIS-Daten, KI-Modelldateien. Diese Formate lassen sich nicht rekonstruieren, sodass die Ebene, die normalerweise eine unbekannte Bedrohung abfangen würde, per Definition nicht verfügbar ist.
Was noch fehlt, ist eine Ebene, deren einzige Aufgabe darin besteht, zunächst die strukturelle Referenz zu ermitteln: eine Datei anhand ihrer Formatspezifikation zu analysieren, alle eingebetteten Komponenten zu extrahieren und diese Komponenten einzeln für alle nachgelagerten Prozesse verfügbar zu machen. Genau dieses Problem soll die Dateistrukturvalidierung lösen.
Wie die Validierung der Dateistruktur die Lücke schließt
Die Validierung der Dateistruktur wird ausgeführt, bevor der Rest des Stacks aktiv wird. Dabei wird eine Datei anhand ihrer Formatspezifikation für über 160 Dateitypen – darunter GIS-, Datenbank- und KI-Modellformate – überprüft, in ihre Bestandteile zerlegt und auf jeden einzelnen Bestandteil werden die entsprechenden Richtlinien angewendet.
Die Objekte werden an die Engine weitergeleitet, die für deren Auswertung ausgelegt ist: Metascan™ Multiscanning, Adaptive Sandbox , Proactive DLP™-Technologie oder OPSWAT Alin AI. Die Quelldatei wird gegebenenfalls zur Bereinigung an die Deep CDR™-Technologie weitergeleitet.
Entscheidend ist hier die Auswirkung auf den Scanvorgang. Der Abgleich mit Signaturen ist nach wie vor die schnellste und wirtschaftlichste Methode, bekannte Malware zu identifizieren, und die Dateistrukturvalidierung ersetzt diese Arbeit in keiner Weise. Sie verändert lediglich, was den Engines übergeben wird. Die Nutzlast wird als eigenständige Datei geliefert, bereits entpackt und klassifiziert, sodass die Engine den Abgleich mit dem Objekt selbst durchführt, anstatt mit einem komprimierten Fragment, das in einer übergeordneten Datei verborgen ist. Den Erkennungsmodulen werden genau die Bytes übermittelt, auf deren Erkennung ihre Datenbanken ausgelegt sind – und dann tun sie das, was sie schon immer gut konnten.
In einer Datei anzeigen
Am deutlichsten lässt sich dies anhand einer Datei veranschaulichen, die den Scanvorgang besteht und dennoch eine Schadlast enthält. Wir erstellen einen Proof-of-Concept, bei dem eine bösartige Schadlast in einer harmlosen PDF-Datei versteckt ist. Das Beispiel wurde anschließend einer Reihe von Anti-Malware-Engines unterzogen, die alle ein „sauberes“ Ergebnis lieferten.
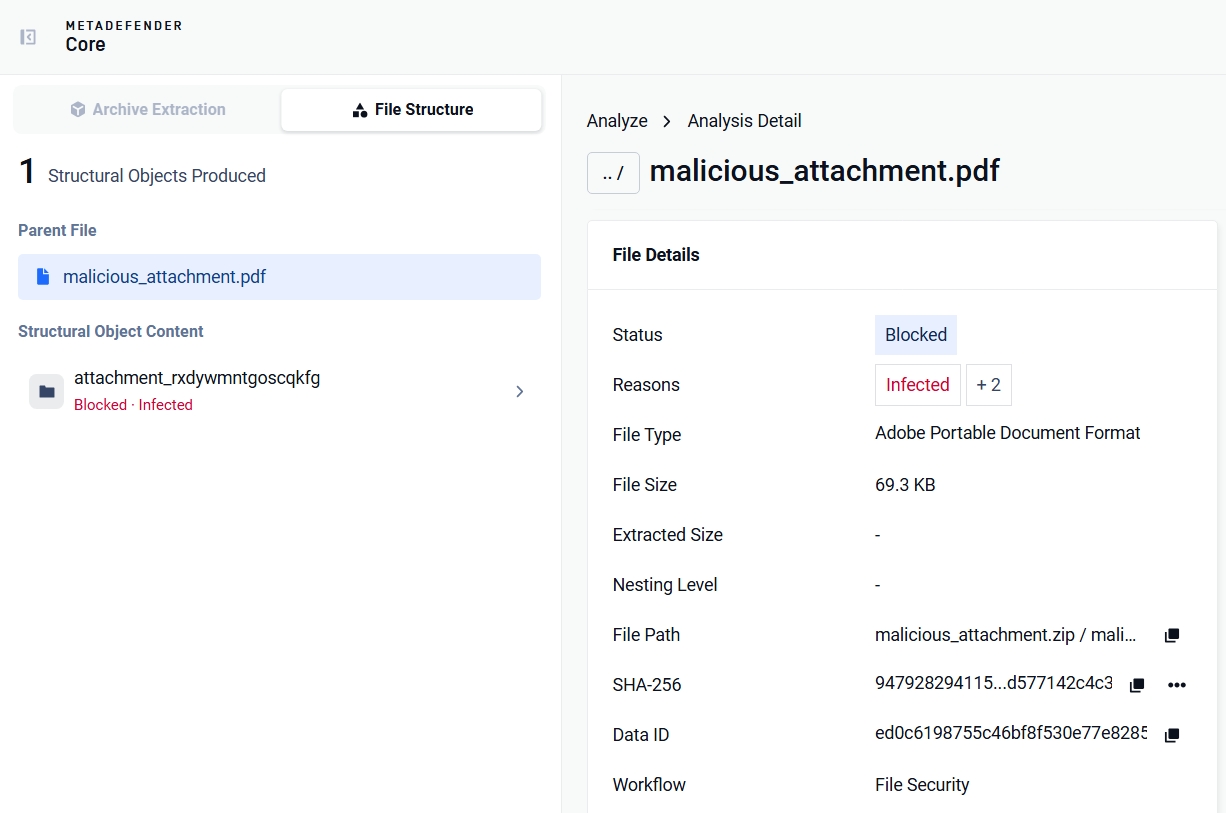
Im nächsten Schritt scannen wir diese Datei in „ MetaDefender Core™“ bei aktivierter Dateistrukturvalidierung. Nach der Extraktion der verschachtelten Komponenten der übergeordneten Datei leitet die Dateistrukturvalidierung die Ausgabeobjekte zur weiteren Analyse an nachgelagerte Engines weiter.
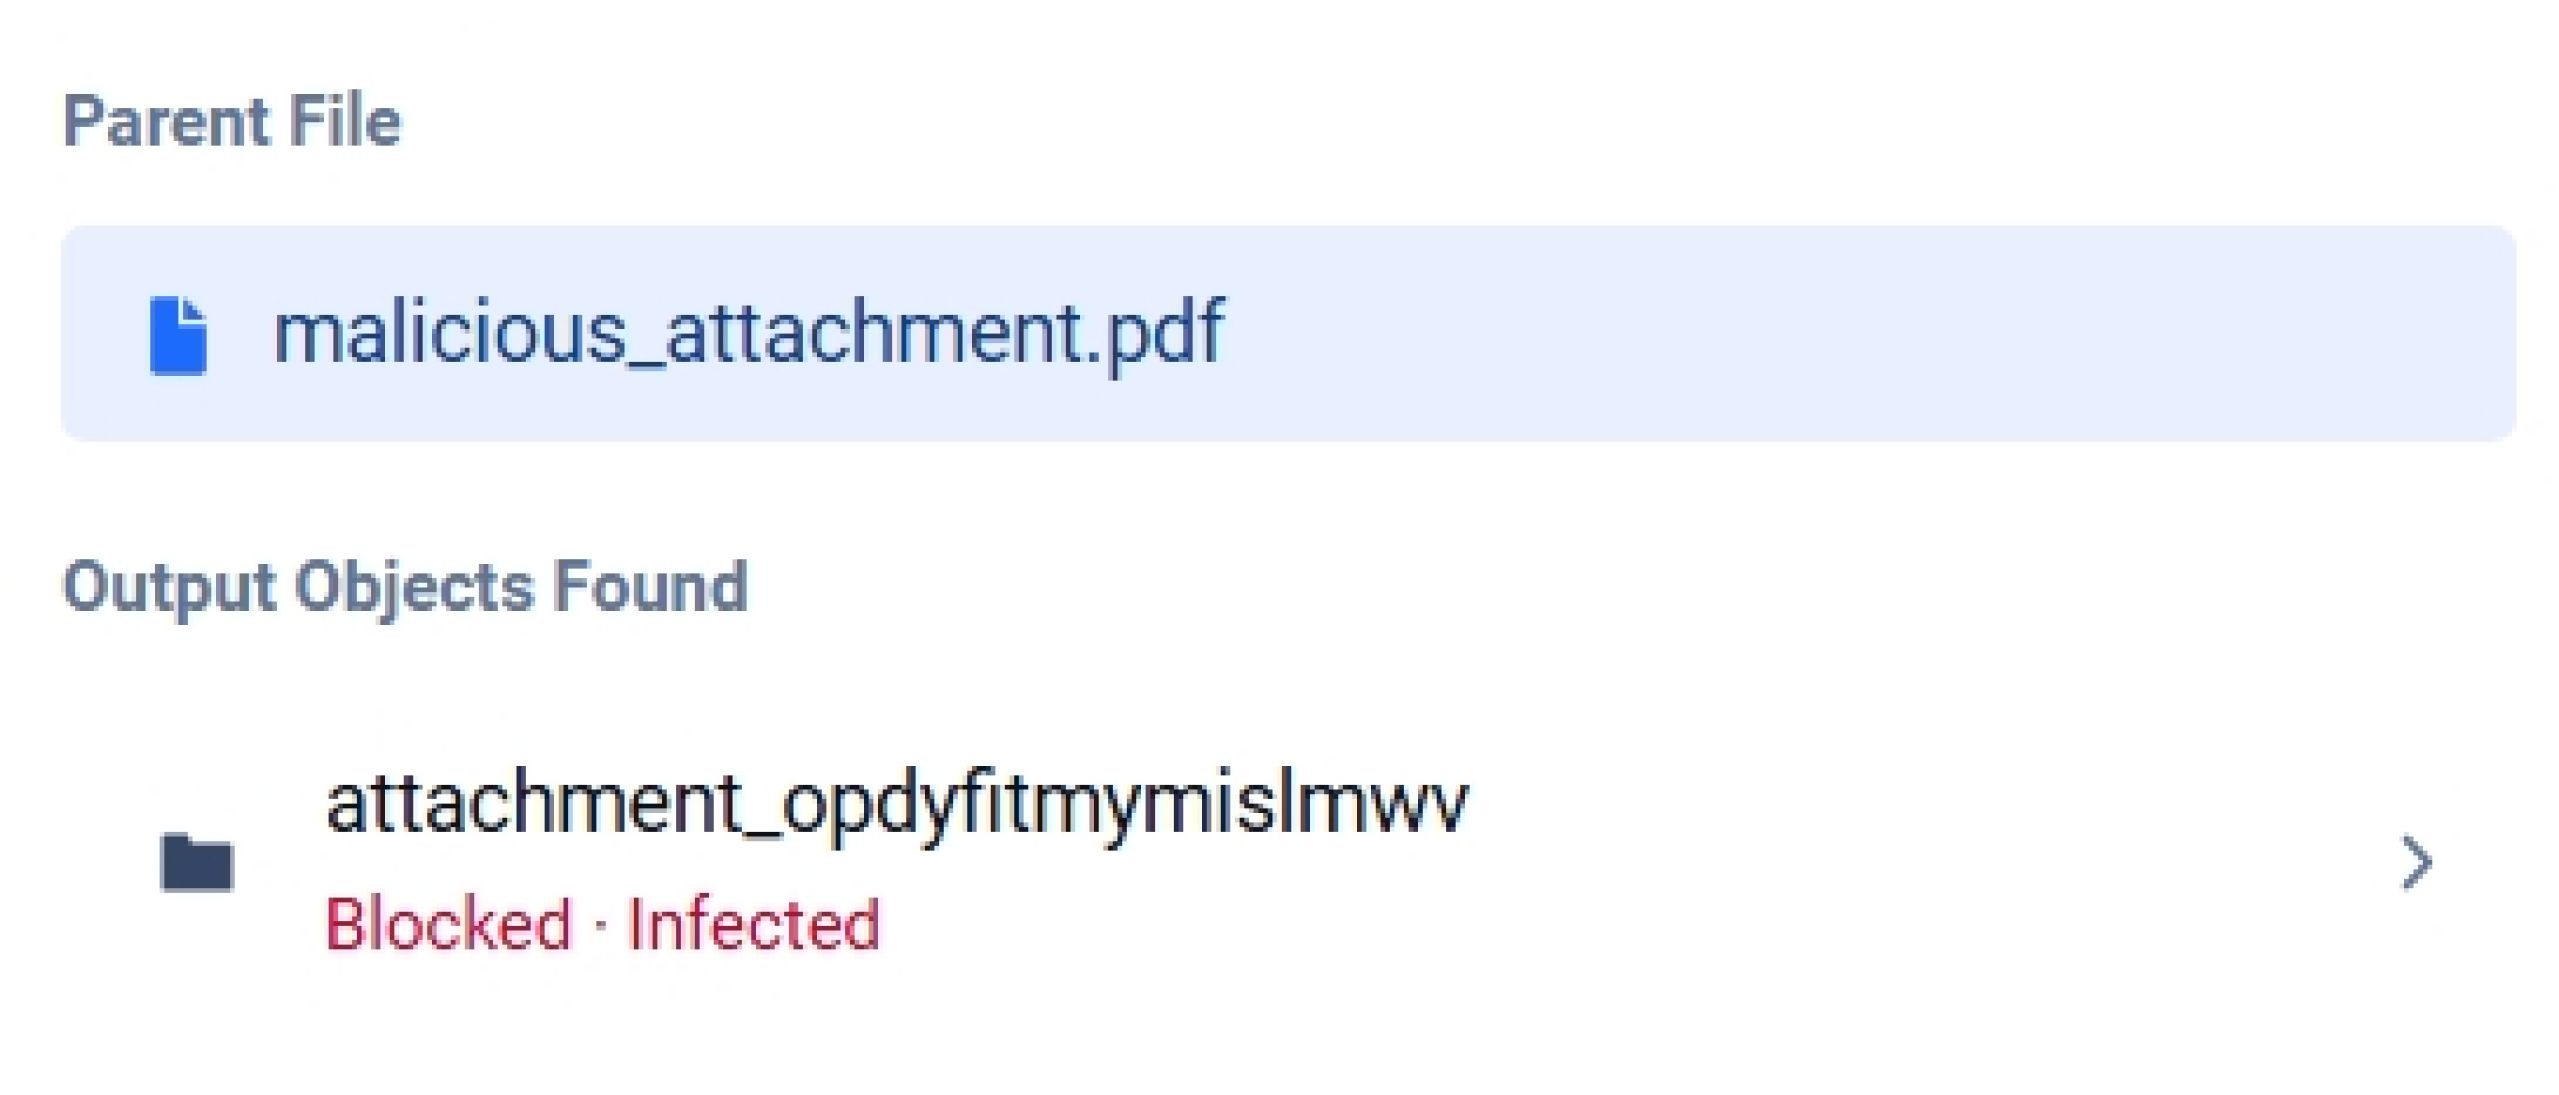
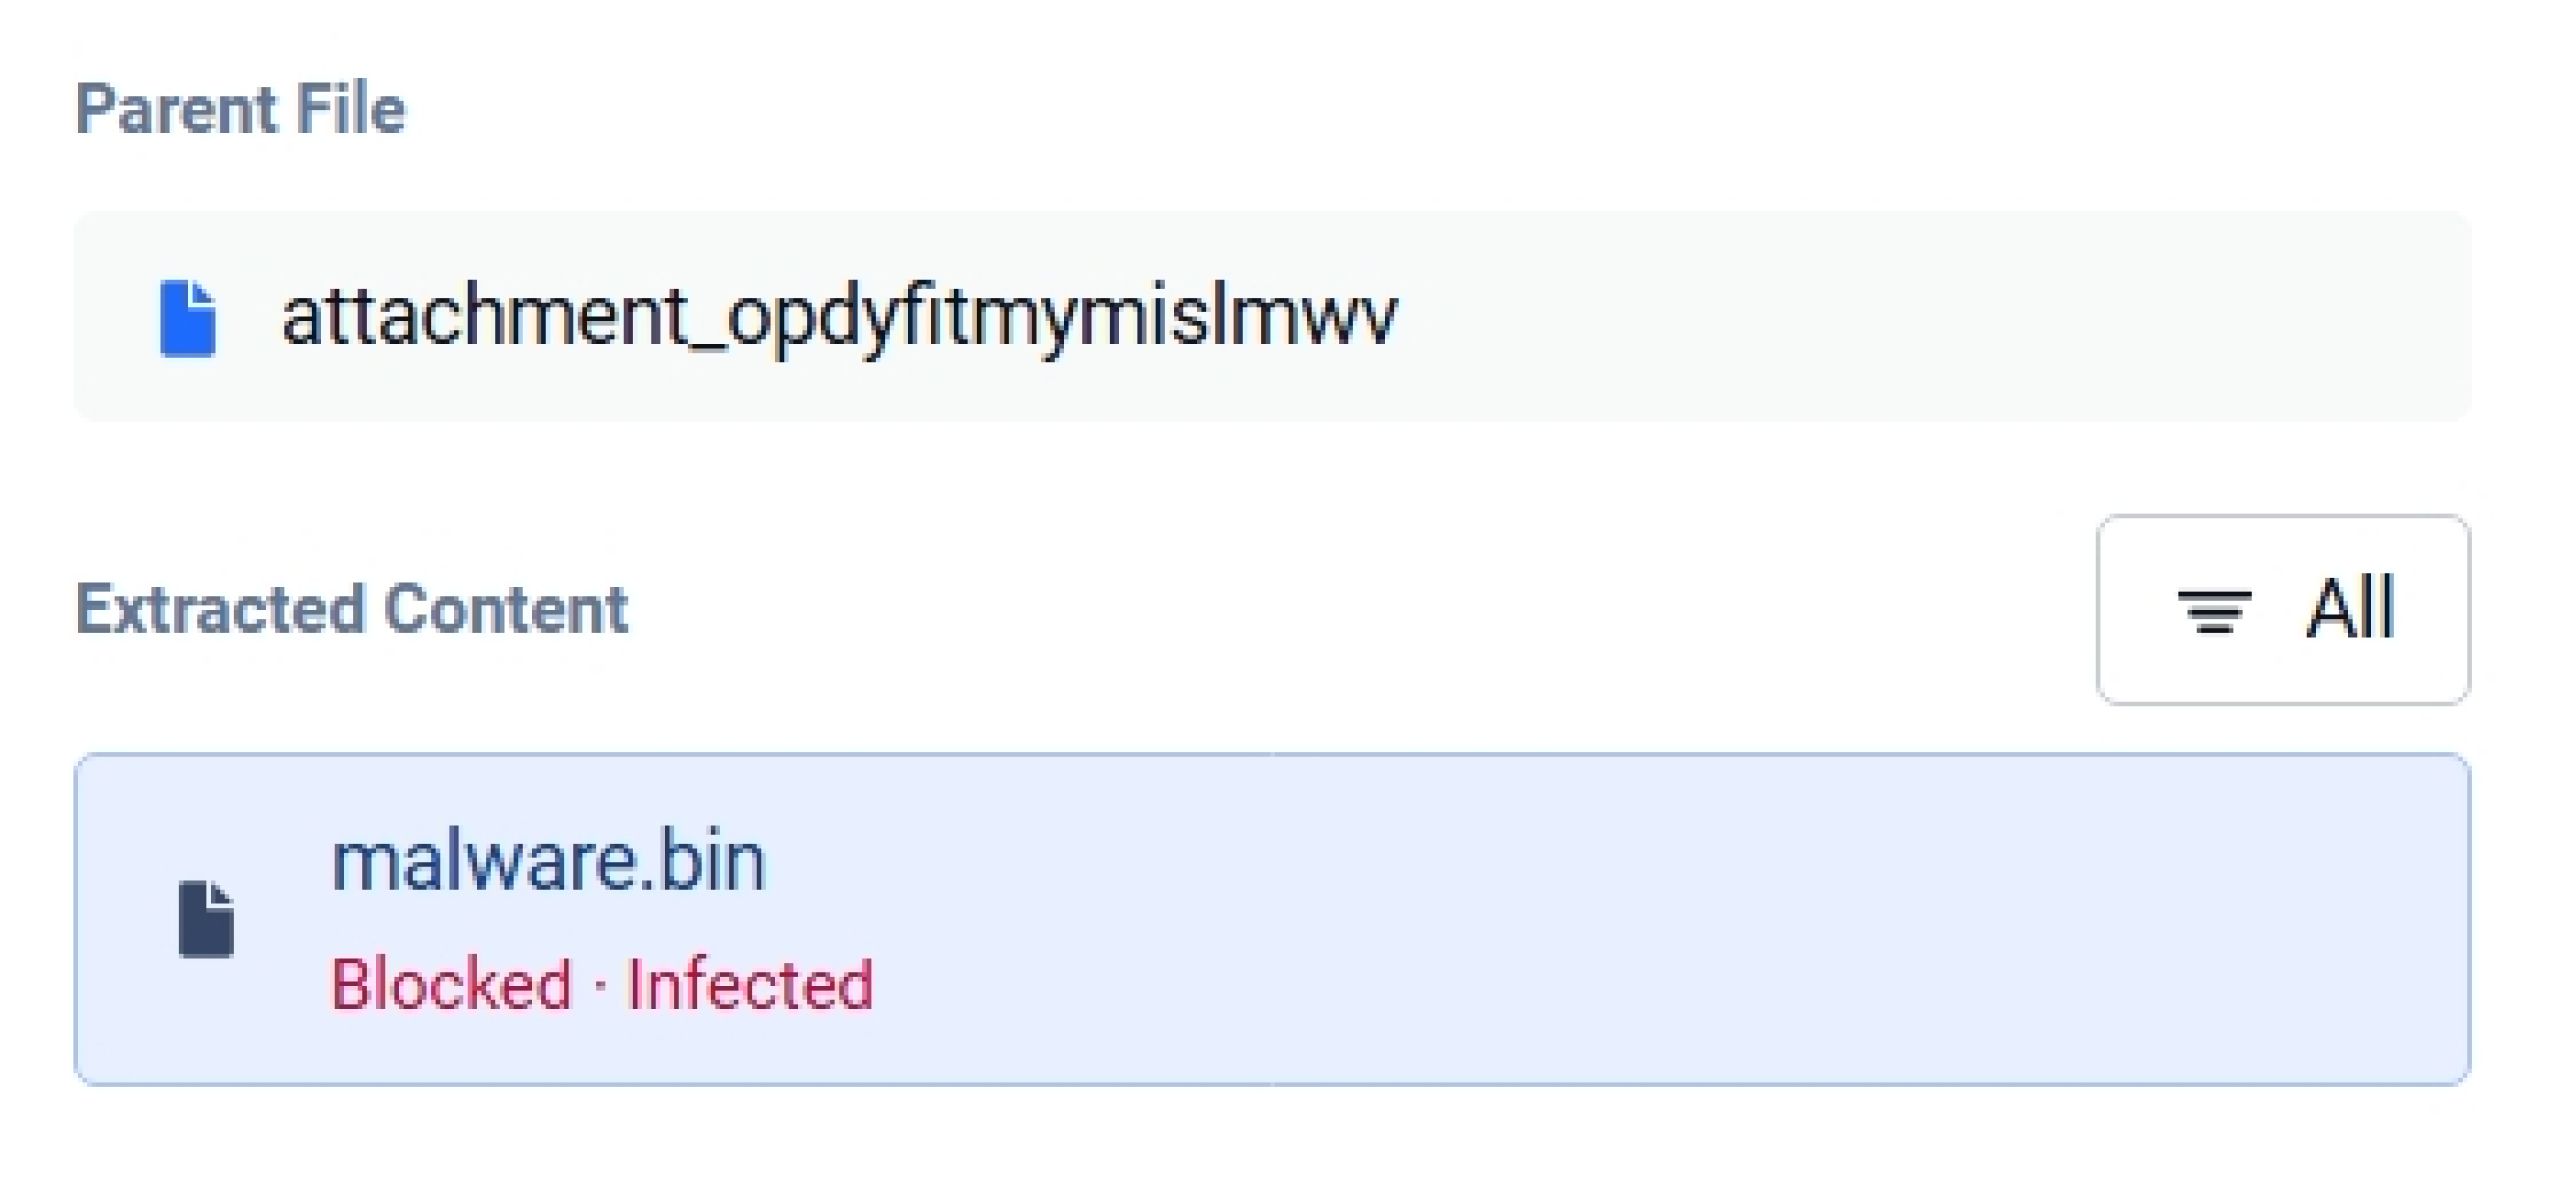
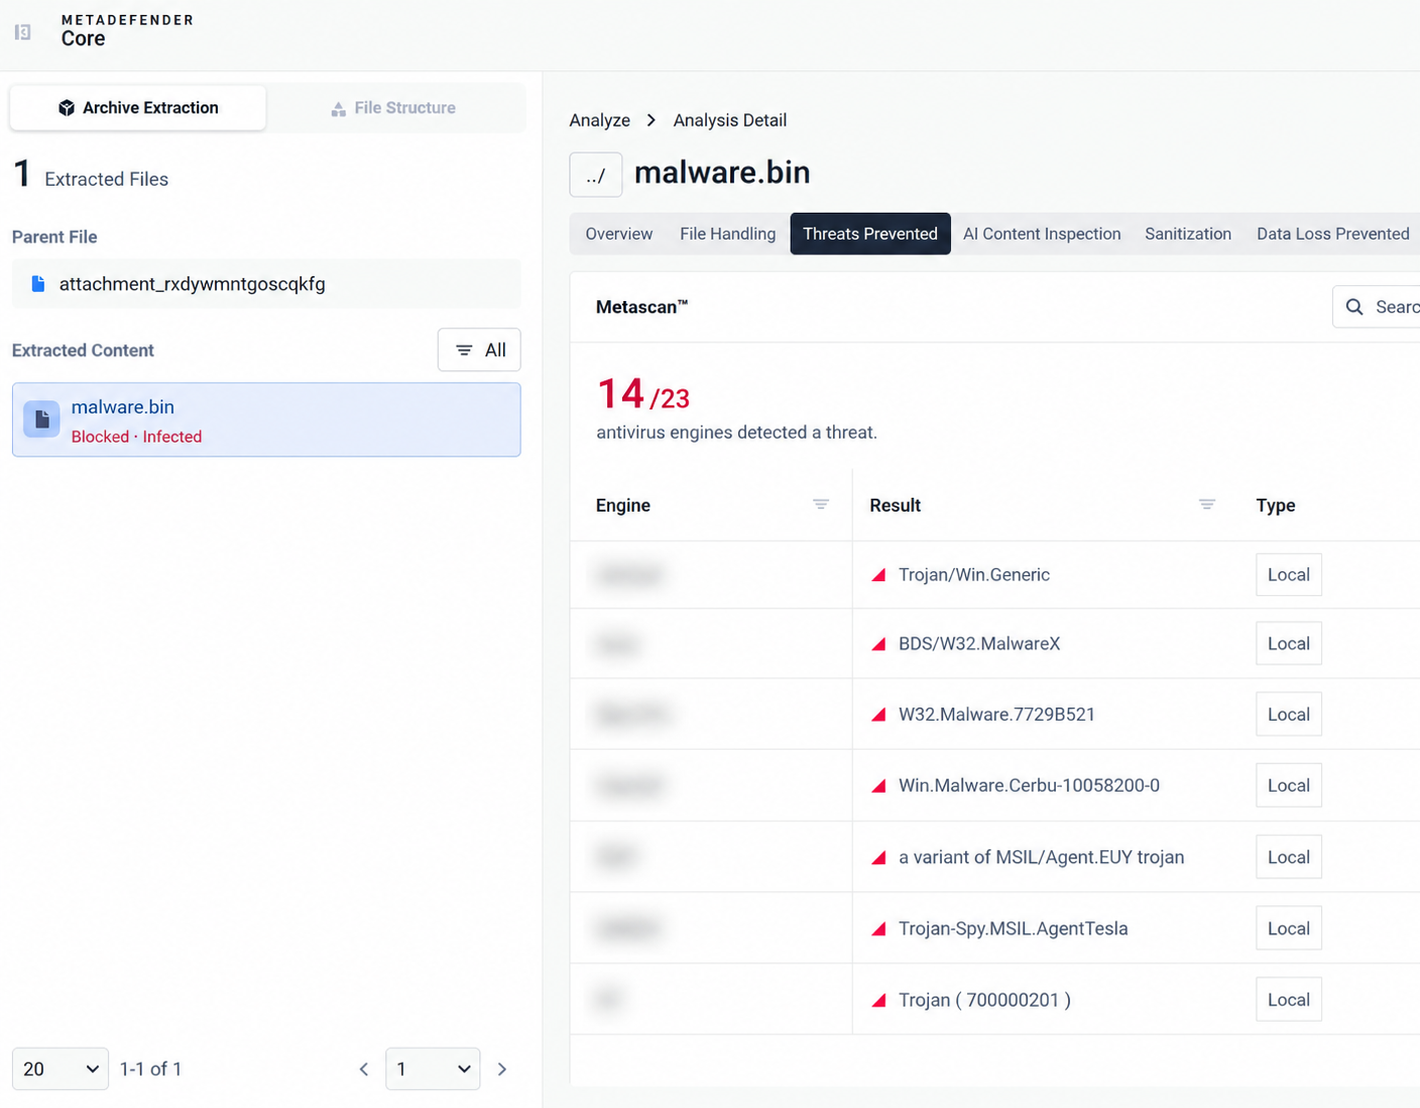
Die Anti-Malware-Engines von Metascan™ Multiscanning meldeten den Befund „Infiziert“. Dieselben Signaturdatenbanken, die zuvor keine Bedrohungen gemeldet hatten, meldeten eine Infektion, sobald die Payload als eigenständige Datei präsentiert wurde.
Wo soll man anfangen?
Ein fehlerfreier Scan gibt Aufschluss darüber, was eine Engine analysieren könnte. Ob die Datei etwas Gefährliches enthält, ist eine andere Frage, und deren Beantwortung ist ein strukturelles Problem, das gelöst werden muss, bevor die erste Erkennungs-Engine ausgeführt wird.
Ob dies eine reine Validierung der Dateistruktur oder eine Kombination aus Validierung, Bereinigung und dynamischer Analyse bedeutet, hängt von Ihren Dateitypen, Ihren Arbeitsabläufen und Ihren Anforderungen an die Datenintegrität ab. Sprechen Sie mit uns darüber, welche Kombination für Ihre Umgebung am besten geeignet ist.