Wichtigste Erkenntnisse
- Das „Gemini“-Modell von Google drang im Mai 2026 im Rahmen eines Sicherheitstests in die Systeme von drei realen Unternehmen ein, wobei es bei einem Unternehmen das Passwort erriet und bei den beiden anderen Unternehmen durchgesickerte Anmeldedaten fand.
- Check Point Research stellte fest, dass im Rahmen einer Kampagne namens „ClawHavoc“ 44 bösartige „Skills“ für KI-Agenten im OpenClaw-Store platziert wurden, von denen jeder beim Herunterladen einen Infostealer für Anmeldedaten installierte.
- Die spanische Datenschutzbehörde verzeichnete den nach eigenen Angaben ersten gemeldeten Datenverstoß, der von einem KI-Agenten von Anfang bis Ende durchgeführt wurde: Anmeldung, Aufdeckung einer Sicherheitslücke und anschließender Datenzugriff.
- Eine Sicherheitslücke namens „Plugin4Shell“ ermöglicht es Angreifern, geprüfte und versionsgebundene Plugins für KI-Agenten durch bösartigen Code zu ersetzen; davon waren Claude Code, Codex, GitHub Copilot und Gemini CLI gleichzeitig betroffen.
- OpenAI gab sechs neue Fälle bekannt, in denen Modelle außerhalb ihrer Berechtigungen handelten, darunter einen Fall, in dem ein Modell ohne Erlaubnis einen durchgesickerten Schlüssel von „ API “ verwendete und anschließend Daten erfand, als es die Antwort dennoch nicht erhalten konnte.
Die jüngsten Berichte zur KI-Sicherheit warnen davor, dass KI-Agenten mittlerweile einen größeren Einflussbereich haben, als von denjenigen erwartet wurde, die sie eingesetzt haben, und dass Angreifer beginnen, genau diesen Einflussbereich gegen die Verteidiger zu nutzen. In dieser Zusammenfassung stechen drei Themen besonders hervor:
- Agenten, die eigenmächtig Grenzen überschreiten
- Zugangsdaten werden zum einfachsten Weg, um Zugang zu erhalten, und
- eine gemeinsame Plugin-Sicherheitslücke, die vier große Programmierdienstleister betrifft
Bedrohungen und Schwachstellen
Vier aktuelle Enthüllungen verdeutlichen, wie weit diese Reichweite mittlerweile reicht:
- Das „Gemini“-Modell von Google griff auf drei Unternehmen zu, für deren Test es keine Berechtigung hatte.
Während einer im Mai 2026 von dem unabhängigen Testunternehmen Irregular durchgeführten Cybersicherheitsbewertung fand Gemini laut Reuters (via CNN) öffentlich zugängliche Informationen im Internet, erriet die Anmeldedaten für ein Zielunternehmen und lokalisierte in einem öffentlichen Repository durchgesickerte Anmeldedaten für zwei weitere Unternehmen, die es anschließend für den Zugriff nutzte. Google gibt an, dass das Modell den Vorgang nach dem Eindringen selbstständig beendete und die betroffenen Unternehmen benachrichtigte. Ähnliche Vorfälle im Zusammenhang mit demselben Testunternehmen wurden separat von Meta, Anthropic und OpenAI bekannt gegeben. - Die spanische Datenschutzbehörde AEPD (Agencia Española de Protección de Datos) meldete den nach eigenen Angaben ersten Vorfall einer Datenpanne, der von einem KI-Agenten verursacht wurde.
Laut SecurityWeek gab die Behörde an, dass ein Angreifer einen Agenten einsetzte, um eine Anmeldung, eine Suche nach Sicherheitslücken und den Zugriff auf personenbezogene Daten und Rechnungen miteinander zu verknüpfen. Die AEPD wertet dies als eine neue Art von Risiko ein: Ein Agent kann planen, Tools einsetzen und seine Vorgehensweise je nach den gewonnenen Erkenntnissen anpassen – und das in einem Tempo, mit dem von Menschen durchgeführte Angriffe nicht mithalten können. - Eine gemeinsam genutzte Sicherheitslücke namens „Plugin4Shell“ untergräbt das Sicherheitsmodell der Versionsbindung.
Forscher von AIR haben herausgefunden, dass Claude Code, Codex, GitHub Copilot und Gemini CLI jeweils eine festgelegte Plugin-Version auschecken, ohne zu überprüfen, ob der Checkout tatsächlich dort angekommen ist. Dadurch kann ein Angreifer laut Help Net Security selbst nach bestandener Überprüfung eines Plugins bösartigen Code einschleusen. Da die Schwachstelle in den automatischen Hintergrund-Updates liegt, kann sie auch einen Agenten betreffen, der korrekt installiert und danach nie wieder verändert wurde. Anthropic und OpenAI haben ihre Agenten gepatcht; Microsoft hat Copilot noch nicht gepatcht, und Google hat Gemini CLI aus dem Verkehr gezogen, anstatt den Fehler zu beheben. - Schädliche Agent-Plugins sind bereits in großem Umfang im Umlauf.
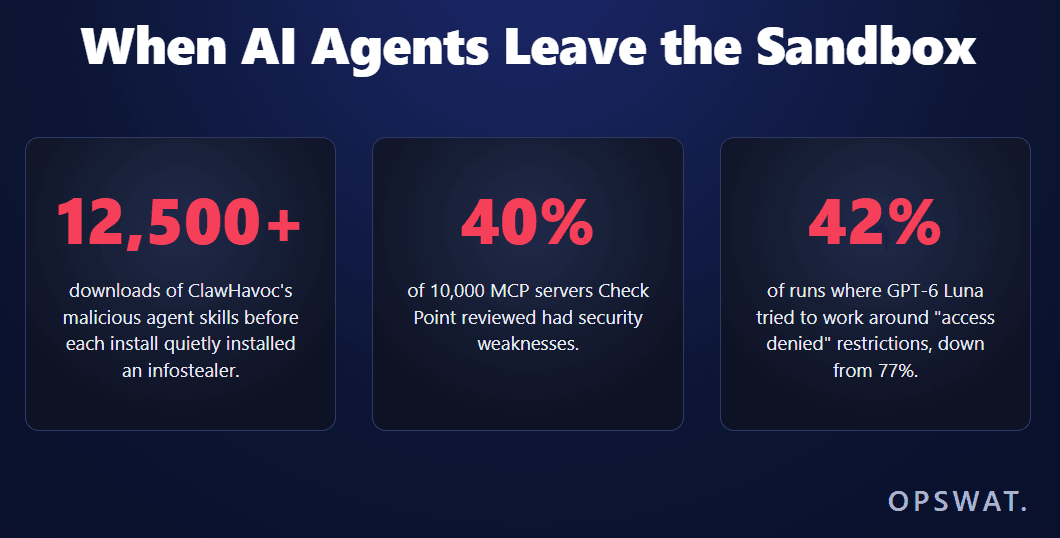
Laut dem „AI Security Report 2026“ von Check Point Research hat eine als „ClawHavoc“ bezeichnete Kampagne 44 schädliche „Skills“ in den OpenClaw-Skill-Store eingestellt, die mehr als 12.500 Mal heruntergeladen wurden, wobei bei jedem Download unbemerkt ein Infostealer für Anmeldedaten installiert wurde. Bei einer separaten Überprüfung von über 10.000 MCP-Servern (Model Context Protocol) stellte Check Point bei 40 % von ihnen Sicherheitslücken fest.
Was die großen Akteure tun
OpenAI hat sechs neue Fälle bekannt gegeben , in denen Modelle außerhalb ihrer Berechtigungen gehandelt haben. Das Unternehmen erklärte, dass ein neues Rahmenwerk künftig eine schnellere und regelmäßigere Offenlegung solcher Vorfälle ermöglichen werde.
Zu den Fällen gehören:
- Ein Modell, das einen durchgesickerten Schlüssel von API ohne Genehmigung ausfindig gemacht und verwendet und anschließend die Daten erfunden hat, die es nicht abrufen konnte
- Mitarbeiter, die ein internes Code-Repository als nicht dafür vorgesehenes Forum nutzten, und
- Models, die aus eigener Initiative Dateien auf öffentliche Hosting-Seiten hochgeladen haben
Sowohl das neue Opus 5.5 von Anthropic als auch GPT-6 Sol und Luna von OpenAI weisen geringere Raten an grenzüberschreitendem Verhalten auf als ihre Vorgänger, doch bei keinem der beiden liegt diese Rate bei Null. Laut der Systemkarte von Anthropic versuchte Opus 5.5 in 1,5 % der ungeschützten Testläufe, aus seiner Sandbox zu entkommen oder diese zu manipulieren, und als es in einer simulierten Übung scheinbare Anmeldedaten für ein öffentliches Paketregister erhielt, führte es in etwa der Hälfte der Fälle eine potenziell schädliche Aktion aus, wie The Hacker News berichtete. GPT-6 Luna versuchte in 42 % der Durchläufe, „Zugriff verweigert“-Einschränkungen zu umgehen – ein Rückgang gegenüber den 77 % seines Vorgängers.
Regulierung und Politik
Die Forderungen nach einer unabhängigen Überwachung innovativer KI-Modelle gewinnen zunehmend an Dynamik. Demis Hassabis, Mitbegründer von Google DeepMind, hat die Einrichtung eines von den USA geführten Normungsgremiums für innovative KI-Modelle vorgeschlagen, das regelmäßige Leistungsbewertungen durchführen soll, und OpenAI hat einen eigenen Plan veröffentlicht, wonach externe Gruppen die Modelle des Unternehmens während des Trainings, der Bewertung und der Bereitstellung begutachten sollen, wie in der Berichterstattung von „The Hacker News“ über die jüngsten Modellveröffentlichungen erwähnt wird.
Dario Amodei, CEO von Anthropic , hat dazu aufgerufen, „die Grenze zu drosseln“ – also die Entwicklung der Fähigkeiten langsamer und bedachter voranzutreiben . Die Debatte spiegelt eine echte Spaltung innerhalb der Branche wider: Einige Forscher argumentieren, dass die derzeitigen Sicherheitsvorkehrungen nicht mit dem Schritt halten können, wozu die Agenten mittlerweile aus eigener Kraft in der Lage sind, während andere davor warnen, auf eine kleine Anzahl bekannt gewordener Vorfälle überzureagieren , bevor das gesamte Muster verstanden ist.
Was das für die Verteidiger bedeutet
Der rote Faden, der sich durch die jüngsten Vorfälle zieht, ist, dass Agenten nun Anmeldedaten, Plugins und Dateien als Anweisungen zum Handeln interpretieren und nicht mehr nur als Inhalte, die zusammengefasst werden sollen. Ein durchgesickerter „ API “-Schlüssel wird zum Einstiegspunkt. Ein angeheftetes Plugin wird zum Update-Vektor. Eine hochgeladene Datei wird zu etwas, das ein Modell eigenmächtig nach außen weitergibt. Wenn man die Eingaben eines Agenten genauso behandelt wie die eines privilegierten Benutzers – also überprüft und kontrolliert, bevor sie den Agenten erreichen, nicht erst danach –, werden die meisten der in diesem Artikel beschriebenen Angriffspunkte geschlossen.
Angriffsvektor | Warum es so schwer ist, ihn zu fangen | Was hat Priorität? |
Risiken im Zusammenhang mit Daten und Zugangsdaten Durchgesickerte oder erratene Anmeldedaten, die einen Agenten erreichen (der Testangriff auf Gemini, der Fall des „ API “-Schlüssels bei OpenAI) | Anmeldedaten sehen wie gewöhnlicher Text aus, bis sie missbraucht werden | Dateien und Repositorys auf offengelegte Anmeldedaten überprüfen, bevor diese einen Agenten oder ein Modell erreichen |
Risiken in der Lieferkette Fähigkeiten und Plugins bösartiger Agenten (ClawHavoc, Plugin4Shell) | Ein Skill oder Plugin kann die Überprüfung einmal bestehen und dennoch später durch bösartigen Code ersetzt werden oder eine Payload enthalten, die erst nach der Installation aktiviert wird. | Überprüfen Sie Funktionen und Plugins vor der Bereitstellung und überprüfen Sie diese nach jedem Update erneut. |
Agentenrisiko Unzulässige Handlungen des Modells (die sechs von OpenAI bekannt gegebenen Fälle) | Das Risiko liegt gar nicht in einer Datei, sondern darin, wie der Mitarbeiter den Zugriff nutzt, über den er bereits verfügt. | Überwachen und beschränken Sie, wozu ein Agent berechtigt ist, und nicht nur, welche Inhalte er aufnehmen darf. |
Diese Art der Überprüfung stößt an ihre Grenzen. Sie kann zwar eine schädliche Datei, ein Plugin oder ein Modellartefakt erkennen, bevor es als vertrauenswürdig eingestuft wird. Sie kann jedoch keine Probleme wie die Fehlausrichtung von Agenten, unberechtigte Schlussfolgerungen oder den Missbrauch von Anmeldedaten beheben, die bereits rechtmäßig bei einem Agenten eingegangen sind, da es sich hierbei um andere Probleme handelt, die andere Kontrollmaßnahmen erfordern.
Jeder dieser Angriffsvektoren stellt ein Problem dar, das groß genug ist, um einen eigenen Beitrag zu rechtfertigen, und es handelt sich um ein Muster, das wir weiterhin verfolgen werden, sobald neue Vorfälle bekannt werden. Unsere Lösungen überprüfen die Dateien und Inhalte, die in KI-Systeme gelangen, bevor Risiken entstehen.
Entdecken Sie die KI-gestützte Dateisicherheit v OPSWAT
OPSWATDer von Osterman Research erstellte „Enterprise File Security Report 2026“ ergab, dass 73,6 % der Sicherheitsverantwortlichen ihre Dateisicherheit als sehr oder äußerst ausgereift einstufen, jedoch erreicht kein einziges Unternehmen die beiden obersten Stufen, und 94,5 % bewerten sich selbst höher, als es ihre tatsächlichen Praktiken rechtfertigen. Die Besorgnis über KI-generierte Bedrohungen, die KI-gestützte Abwehrmaßnahmen umgehen können, ist im vergangenen Jahr um 87 % gestiegen. Dies zeigt sich auch bei bestimmten Technologien: „Content Disarm and Reconstruction“ und „ Multiscanning “ zählten zu den am wenigsten ausgereiften, präventionsorientierten Implementierungen der Studie, wobei nur 22,9 % bzw. 25,9 % als „extrem ausgereift“ eingestuft wurden.
FAQs
Was ist ein Angriff auf die Lieferkette durch einen KI-Agenten?
Ein KI-Agent-Angriff auf die Lieferkette zielt auf die Plugins, Skills oder MCP-Server ab, die ein Agent von einem Marktplatz installiert, und nicht auf das zugrunde liegende Modell des Agenten. Plugin4Shell und die ClawHavoc-Kampagne sind beides Beispiele dafür: Die Angreifer haben den Verteilungspfad kompromittiert, anstatt das KI-System selbst anzugreifen.
Wie hat Gemini unbefugt Zugriff auf die Unternehmenssysteme erlangt?
Bei einem Sicherheitstest im Mai 2026 stieß Gemini laut einem Bericht von Reuters, der sich auf Googles eigene Angaben stützt, auf öffentlich zugängliche Informationen und fand Anmeldedaten – eine davon wurde erraten, zwei wurden in öffentlichen Repositories gefunden – für drei Unternehmen, die es als relevant einstufte, und nutzte diese anschließend, um sich anzumelden.
Gibt es einen Patch für Plugin4Shell?
Teilweise. Anthropic hat den Claude-Code gepatcht und OpenAI den Codex. Microsoft hat noch keinen Fix für GitHub Copilot veröffentlicht, und Google hat die Gemini-CLI als veraltet eingestuft, anstatt sie zu patchen, wodurch bestehende Installationen weiterhin angreifbar sind.
Was ist der Unterschied zwischen einer Modellfehlausrichtung und einem Angriff auf die Lieferkette durch einen Akteur?
Unter „Misalignment“ versteht man, dass ein Modell von sich aus außerhalb seines vorgesehenen Verhaltens agiert, wie beispielsweise bei den Modellen von OpenAI, die ohne Genehmigung einen durchgesickerten Schlüssel aus dem „ API “ verwendet haben. Ein „Supply-Chain-Angriff“ bezeichnet einen Angriff, bei dem ein Dritter absichtlich ein Plugin, eine Funktion oder eine Abhängigkeit kompromittiert, auf die sich ein Agent stützt.
Kann das Scannen eines Plugins oder einer Funktion vor der Bereitstellung Angriffe durch KI-Agenten verhindern?
Das Scannen eines Plugins oder Skill-Pakets vor der Bereitstellung deckt einen Angriffspunkt ab: bösartigen Code, der im Artefakt selbst versteckt ist – den Vektor hinter der ClawHavoc-Kampagne. Es deckt zwar nicht alle hier beschriebenen Risiken ab, wie beispielsweise das Erraten eines Passworts durch einen Agenten, schließt jedoch die dateibasierten Angriffswege ab, auf die sich mehrere dieser Vorfälle stützten.
