Die Datei, die jede Prüfung besteht
Dateisicherheits-Pipelines basieren auf einer Annahme, die selten in Frage gestellt wird: Eine Datei hat einen Typ. Der Detektor weist ihr diesen zu, und die Richtlinie leitet sie entsprechend weiter. Jede nachgelagerte Engine analysiert die Datei dann entsprechend diesem Typ: Malware-Schutz, Sandbox und Bereinigung.
Polyglot-Dateien widerlegen diese Annahme. Ein einzelner Byte-Strom kann gleichzeitig ein vollkommen gültiges GIF und ein vollkommen gültiges Java-Archiv sein. Der gleiche Trick funktioniert auch bei einem JPEG, das gleichzeitig ein RAR-Archiv ist, oder bei einem PDF, das über sein logisches Ende hinaus ein vollständiges ZIP enthält. Jede Komponente entspricht für sich genommen den Standards, sodass kein einzelner Format-Parser einen Fehler feststellt.
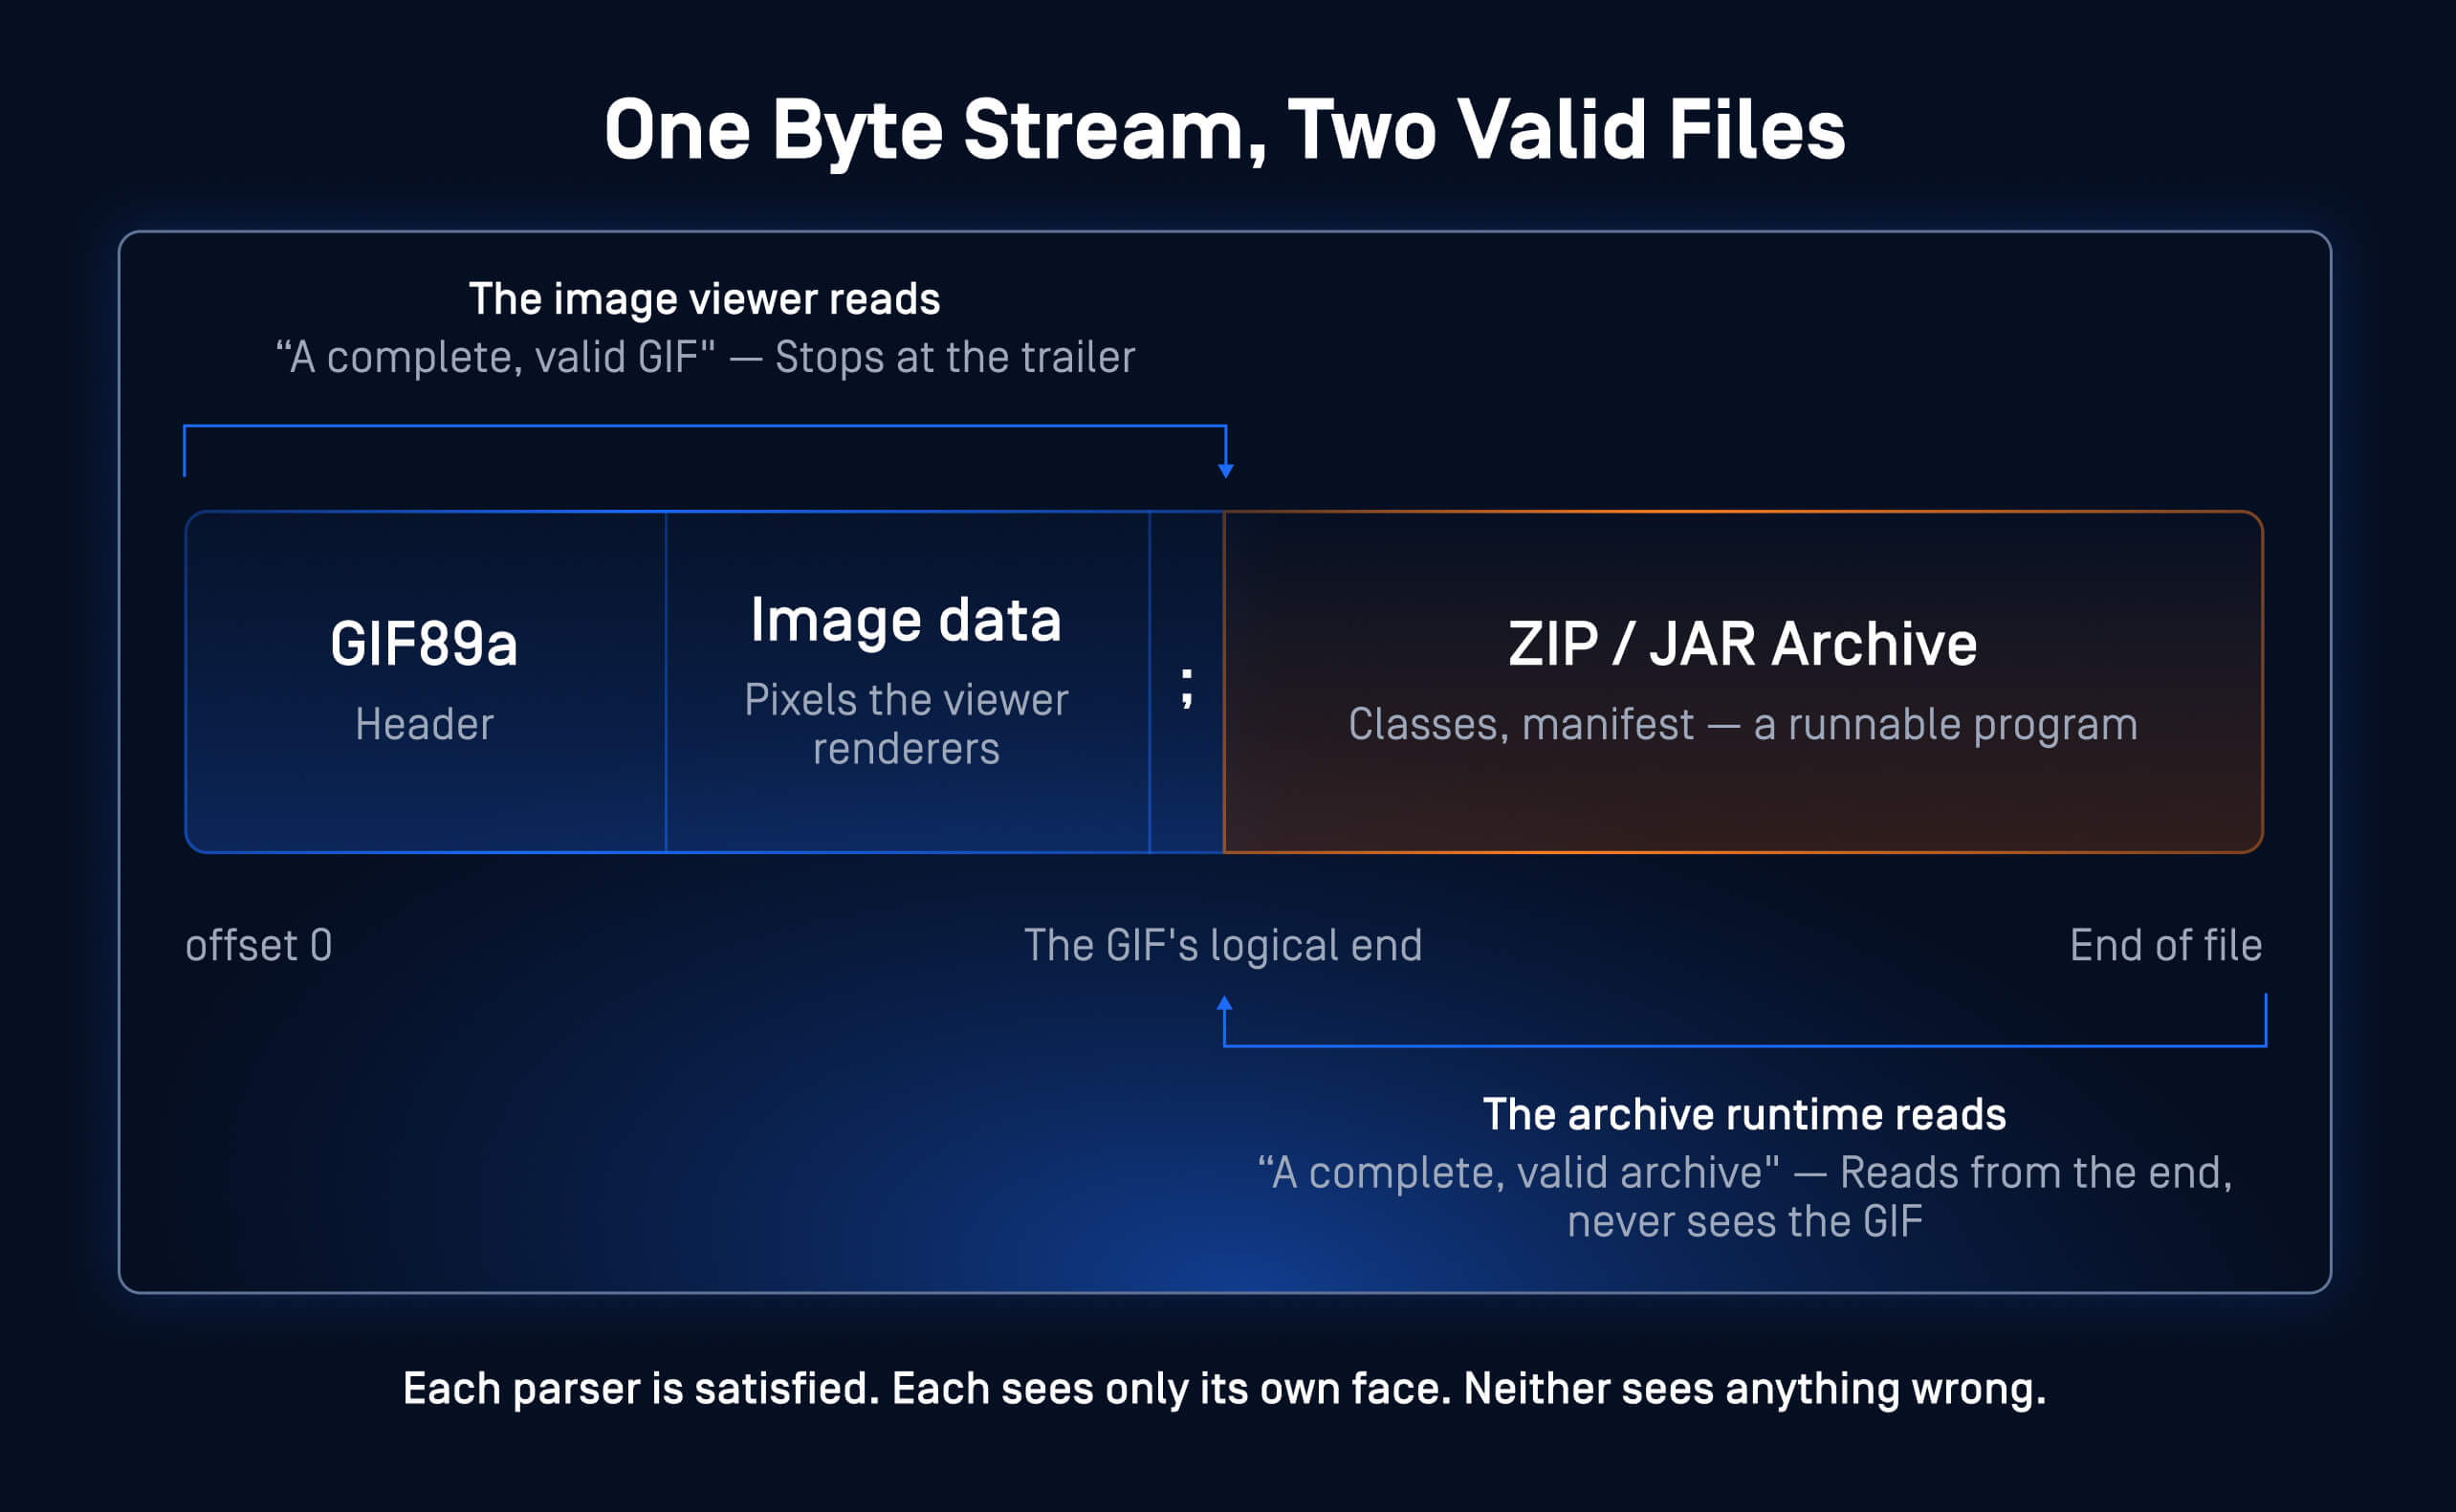
Ein Vielsprachiger in einem Bild: das klassische GIF+JAR. Zwei Parser, zwei Einstiegspunkte, eine Datei – und jedes Gesicht ist vollständig gültig.
Die sicherheitstechnische Konsequenz ist eindeutig: Die Pipeline scannt die Datei als den von ihr erkannten Typ, während das andere Format unberührt bleibt. Ein Bild, das gleichzeitig ein Skript ist, wird zu einem gespeicherten XSS, wenn eine Webanwendung es zurückliefert. Ein hinter einer Bildfassade verstecktes Archiv schmuggelt seine Nutzlast an Inhaltsfiltern vorbei. Auf dieser Idee aufbauende Angriffsketten – von der klassischen GIF+JAR-Kombination bis hin zur steganografiegestützten Exploit-Verteilung – sind seit fast zwei Jahrzehnten bekannt. Anti-Malware-Engines erkennen sie nach wie vor größtenteils nicht, da jedes Bild, für sich betrachtet, harmlos ist.
Wie der Motor ein zweites Gesicht findet
Unsere Engine zur Validierung der Dateistruktur umfasst eine Erkennung verschiedener Dateiformate als Vorverarbeitungsschritt, der bei jeder gescannten Datei vor der Verarbeitung durch einen Formatprozessor ausgeführt wird. Das Konzept basiert auf drei Grundgedanken.
- Den gesamten Datenstrom durchsuchen. Der Scanner vergleicht die gesamte Datei mit einer Liste von Format-Magic-Signaturen. Ein zweites Format, das an einer beliebigen Stelle im Datenstrom auftaucht, wird mit seinem genauen Offset angezeigt, selbst wenn für die Datei bereits ein Typ erkannt wurde. Dazu gehören auch Signaturen, die nach dem Dateiende-Marker einer PDF-Datei angehängt oder hinter den Pixeldaten eines Bildes versteckt sind.
- Man muss wissen, wo ein Format tatsächlich endet. Container -Formate können rechtmäßig andere Dateien enthalten. Ein Bild in einer ZIP-Datei ist gewöhnlicher Inhalt. Der Detektor ermittelt das tatsächliche Ende jedes Containers anhand der ihm eigenen Struktur. Der Trailer einer PDF-Datei, das zentrale Verzeichnis einer ZIP-Datei und die Sektorzuordnung einer OLE-Datei (Object Linking and Embedding) markieren jeweils diese Grenze. Bei der PDF-Analyse werden inkrementelle Aktualisierungen berücksichtigt. Nur Signaturen außerhalb dieser Struktur gelten als zweites Merkmal. Diese strukturelle Grenze ist es, die bei jedem gewöhnlichen Archiv einen echten „Polyglot“-Befund von einem Fehlalarm unterscheidet.
- Überprüfen Sie die Angaben, bevor Sie Anschuldigungen erheben. Die Engine extrahiert jedes potenzielle Ergebnis aus dem Datenstrom und identifiziert es unabhängig mithilfe unserer Dateityp-Engine, bevor es gemeldet wird. Ergebnisse, die als unstrukturierte Daten identifiziert werden, werden verworfen. Ein positives Ergebnis bedeutet, dass an dieser Stelle tatsächlich ein zweites Format analysiert wird. Vereinzelte „magische Bytes“ allein führen niemals zu einem solchen Ergebnis.
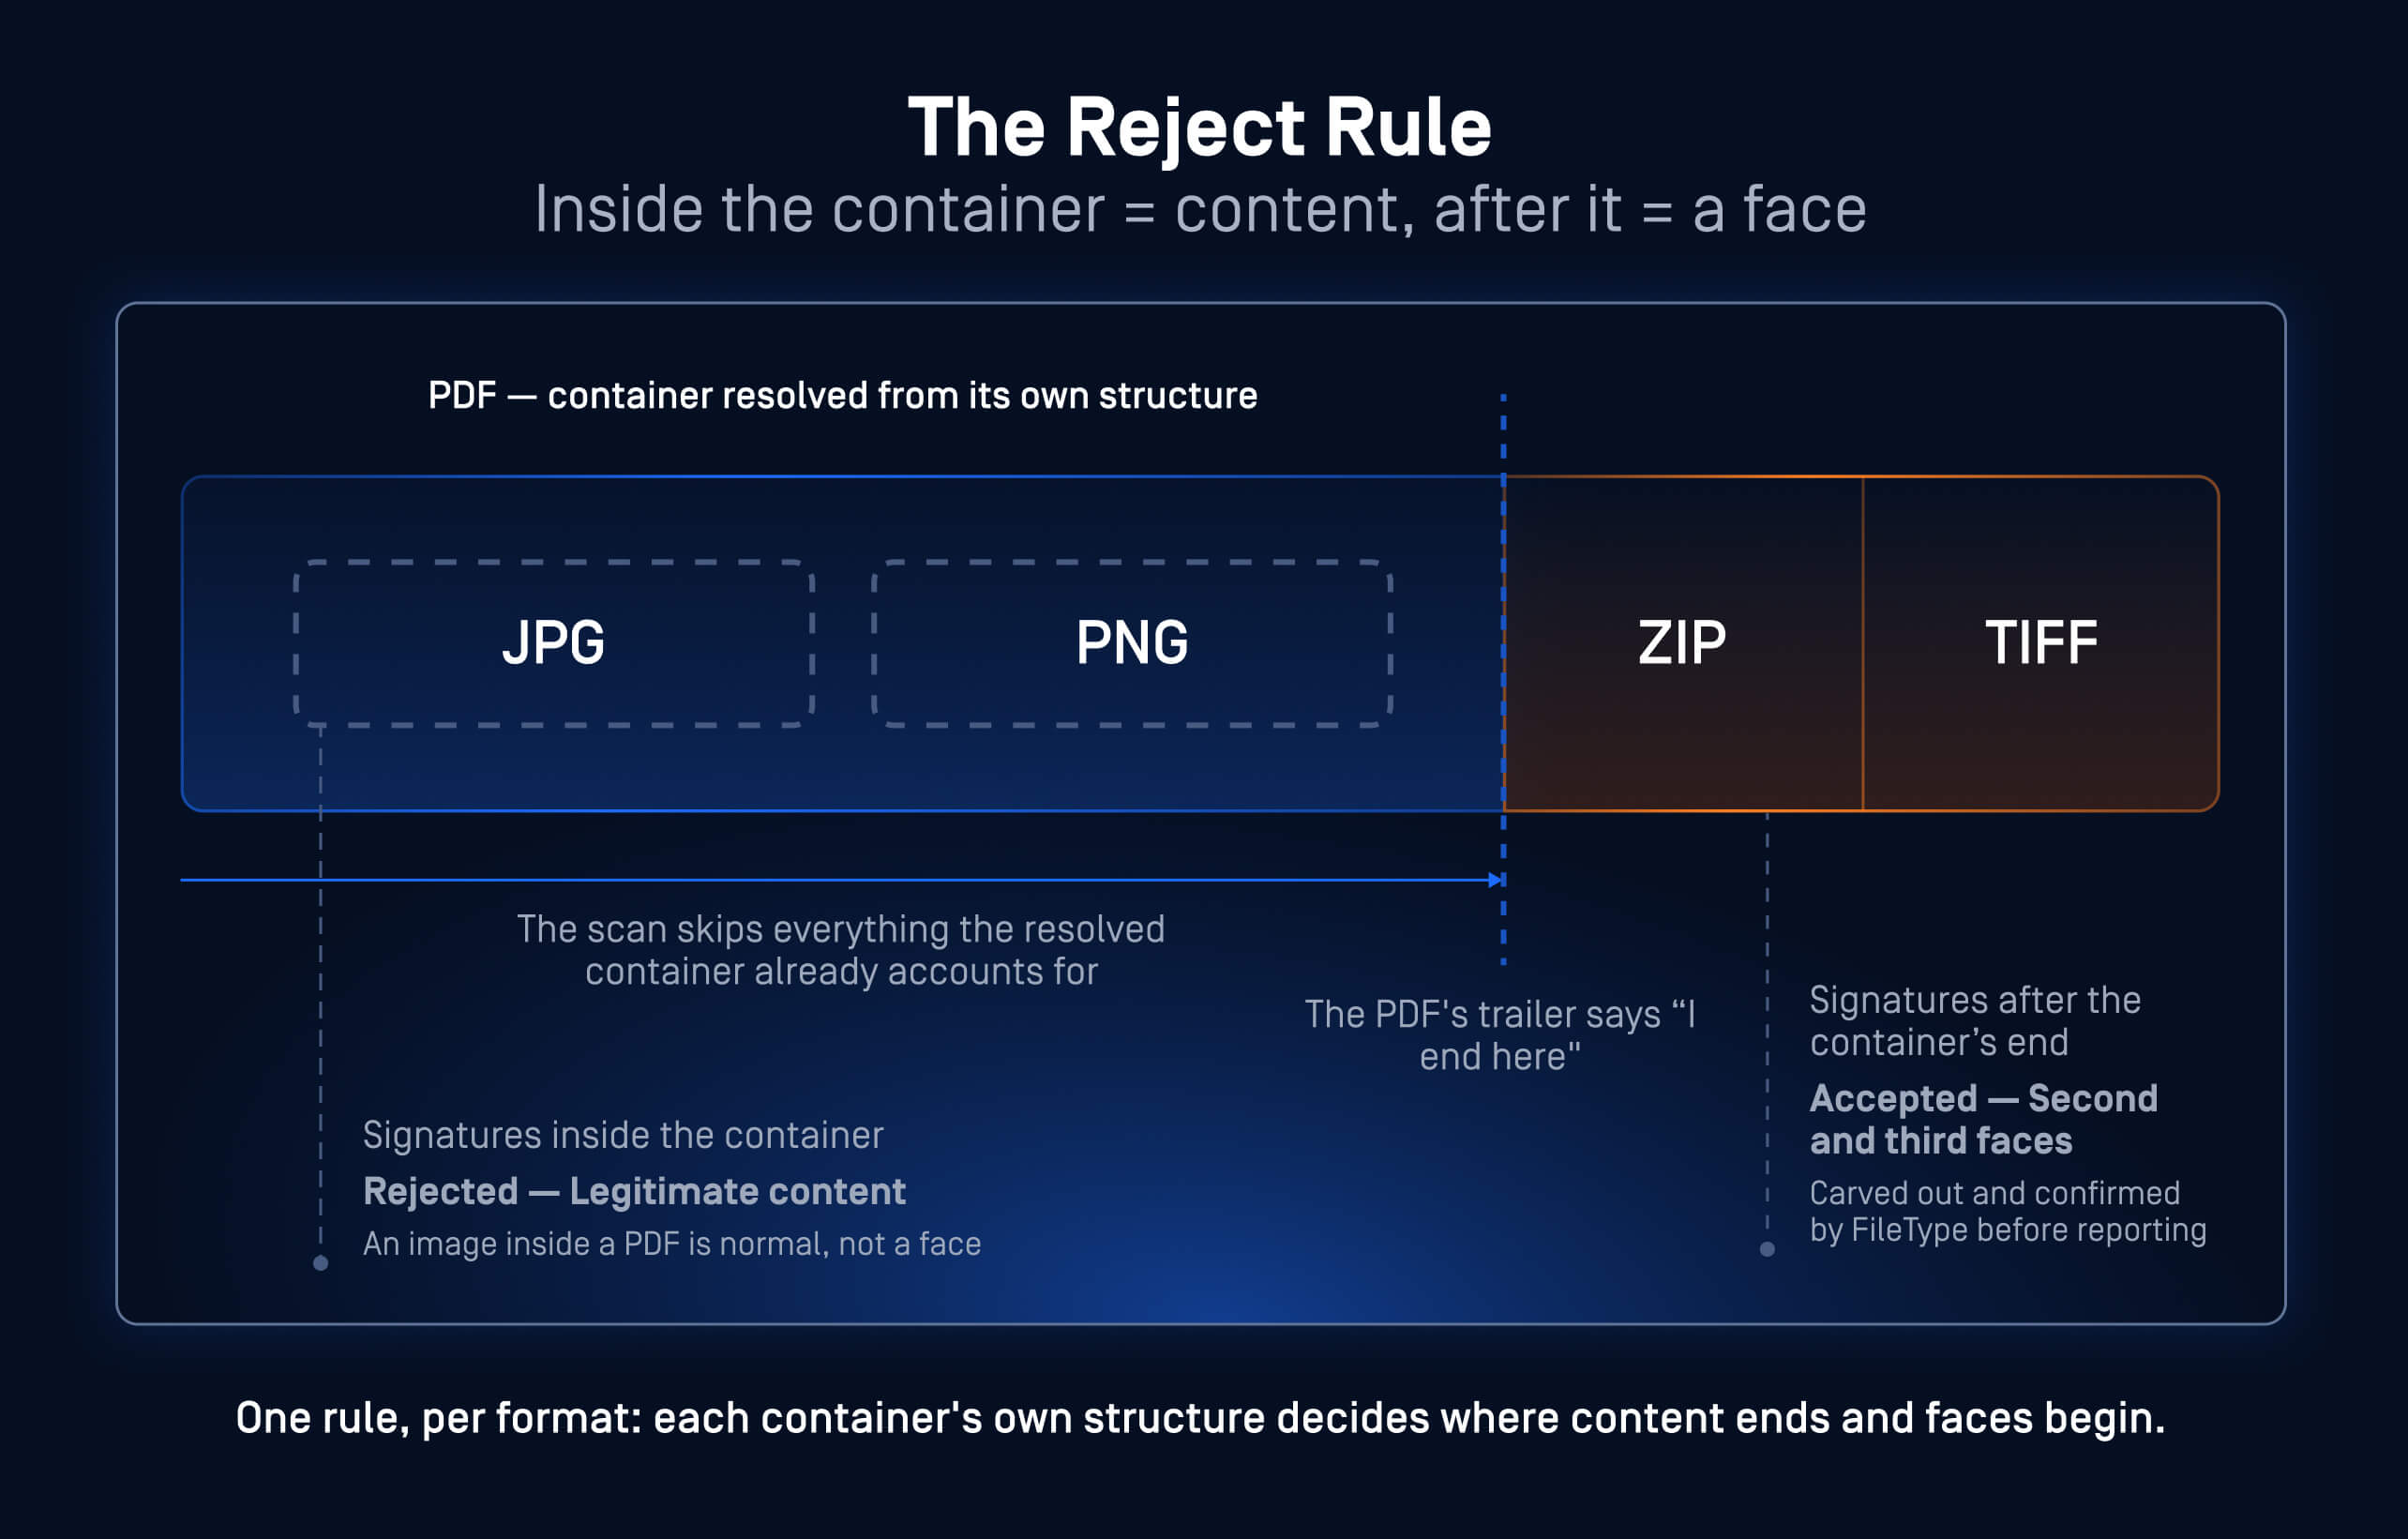
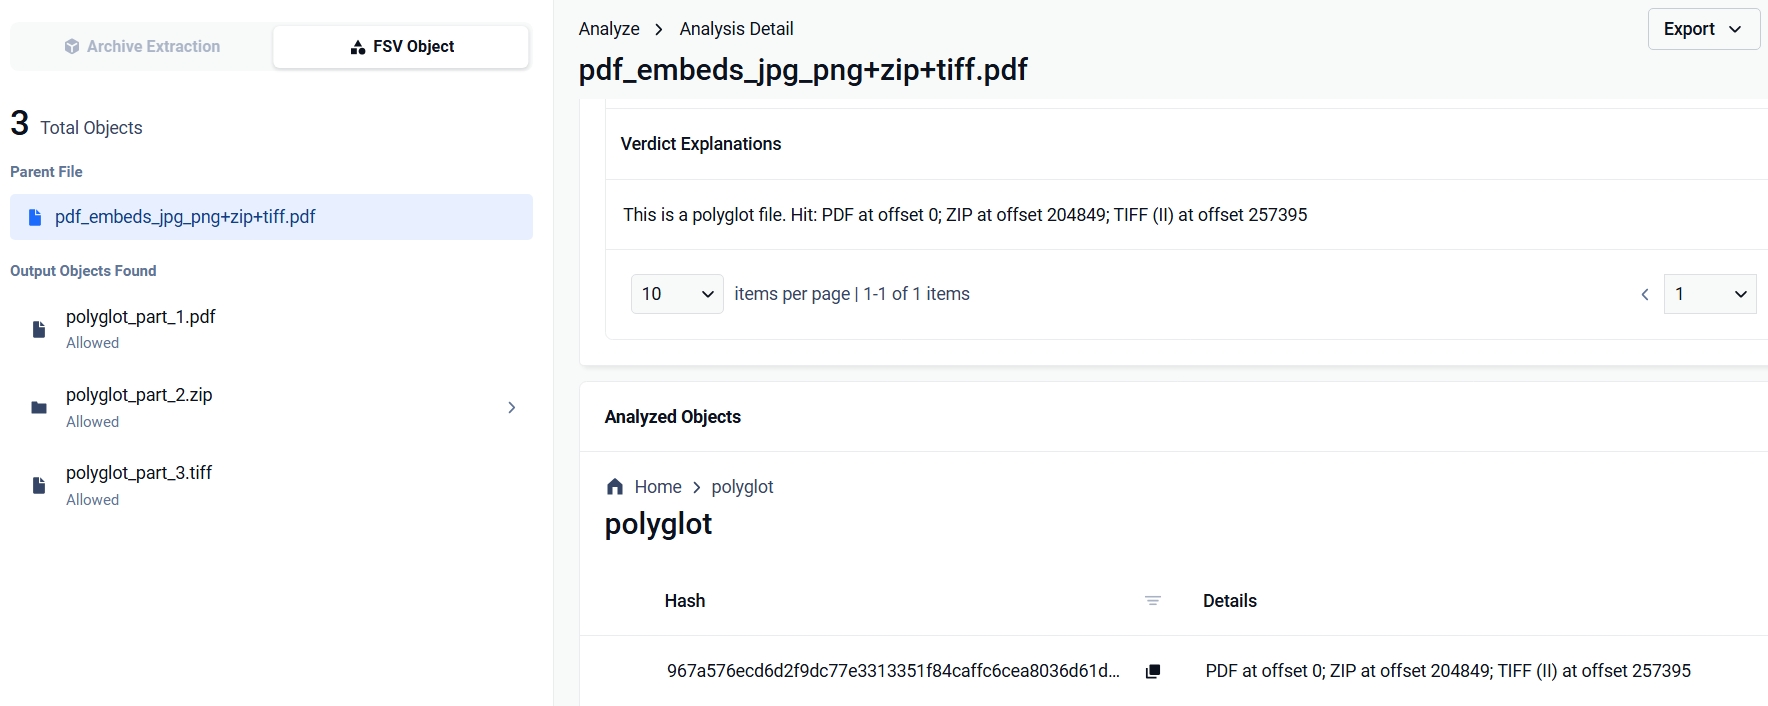
Beispiel aus der Praxis: Eine PDF-Datei, in die ein JPG- und ein PNG-Bild eingebettet sind, an deren logisches Ende eine ZIP- und eine TIFF-Datei angehängt sind. Das Ergebnis nennt die ZIP- und die TIFF-Datei, geht jedoch nicht auf die eingebetteten Bilder ein.
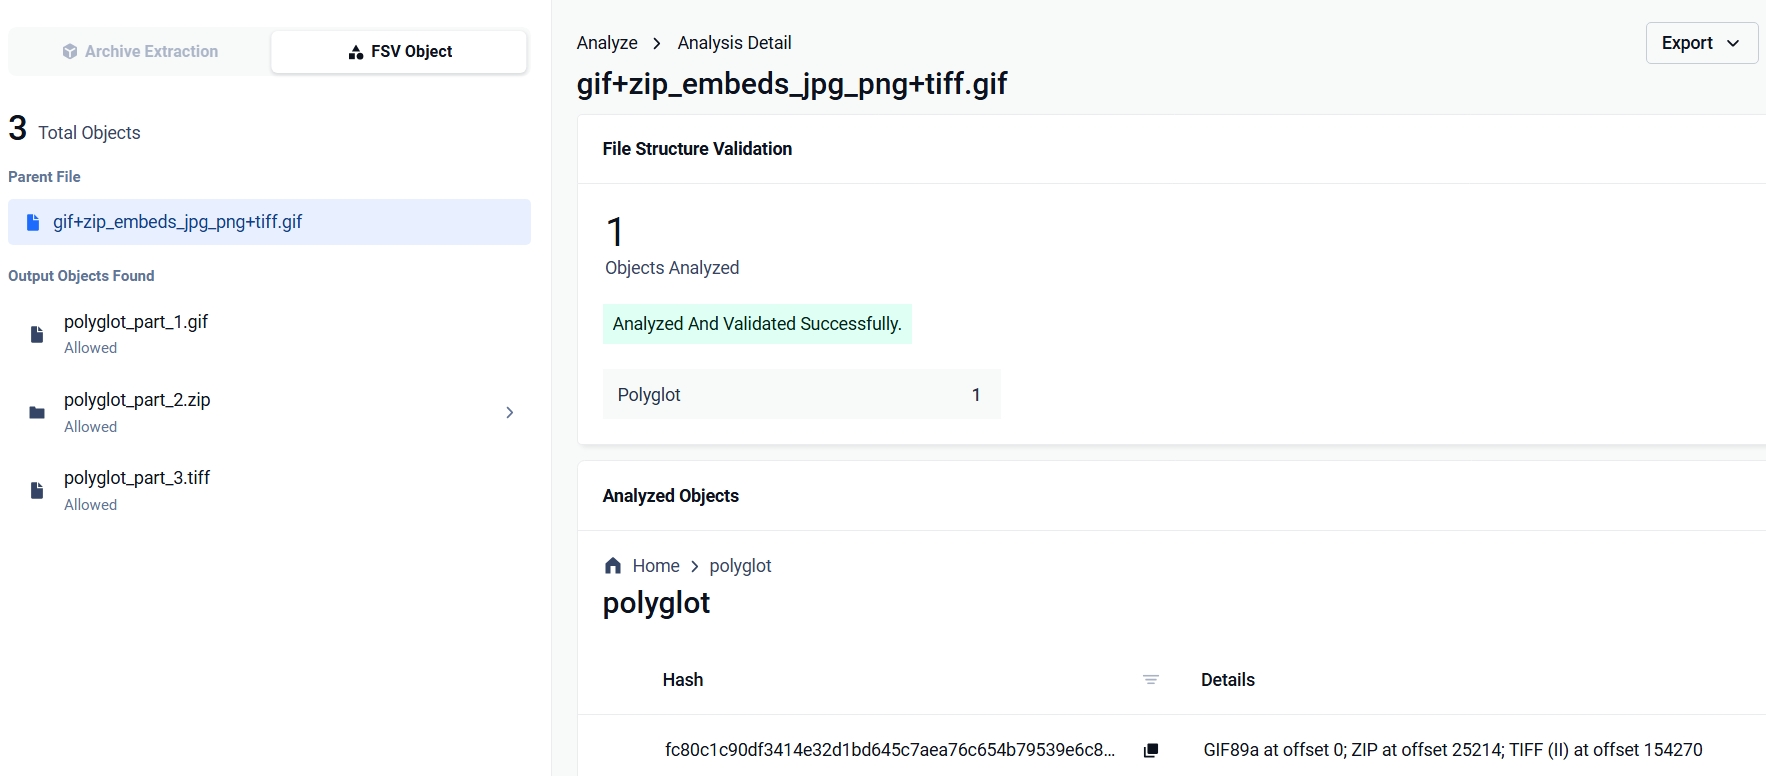
Das Ergebnis meldet jede Ebene mit ihrem Offset. Ein einzelner .gif-Upload wird beispielsweise als GIF89a mit dem Offset 0 und weiter hinten im Stream als ZIP-Archiv identifiziert. Die Richtlinie entscheidet über den weiteren Verlauf: Entweder wird der Befund gemeldet oder die Datei wird direkt blockiert, wobei eine Erklärung mit einer Auflistung der Treffer angegeben wird.
Von der Erkennung bis zur Analyse
Die Erkennung ist nur die halbe Miete, denn der Clou bei „Polyglot“ besteht darin, dass jedes einzelne Gesicht für sich genommen harmlos aussieht. Nach der Erkennung zerlegt die Engine die Datei. Jedes bestätigte Gesicht wird als eigenständiges Objekt (polyglot_part_1.pdf, polyglot_part_2.zip usw.) mit seinem Format, seinem Offset und seiner Größe exportiert. Die Engine übergibt jedes einzelne Objekt an den „MetaDefender Core™“-Workflow, damit es entsprechend seiner tatsächlichen Beschaffenheit vollständig verarbeitet wird.
Wir haben dies auf einer Live-Instanz von „ MetaDefender Core™“ von Anfang bis Ende überprüft.
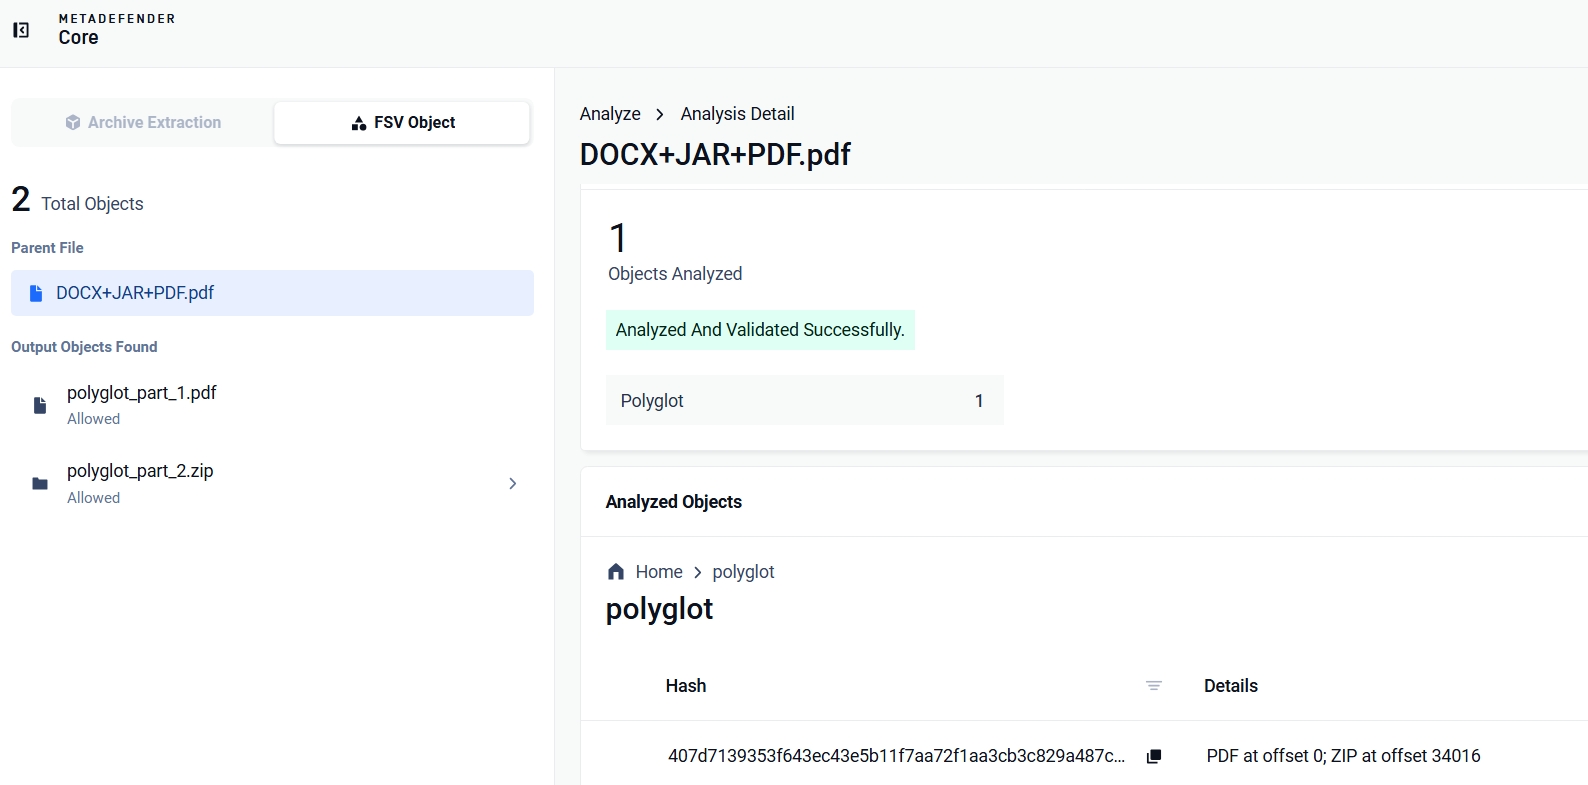
Die Engine hat eine PDF-Datei, die heimlich ein Word-Dokument enthielt (ein „PDF+JAR+DOCX“-Polyglott), in ihre PDF-Schicht und ihre ZIP-Schicht aufgeteilt. Da sowohl JAR als auch DOCX ZIP-Container sind, erfüllt eine ZIP-Schicht beide Spezifikationen. Die Dateityp-Engine identifizierte diese Schicht daraufhin als DOCX, und die Deep CDR™-Technologie bereinigte sie separat. Die versteckte Schicht wird genau so behandelt, wie sie ursprünglich umgangen werden sollte.
Präzision ist das Schwierige daran
„Magic Bytes“ kommen ganz natürlich in harmlosen Dateien vor, daher besteht der eigentliche technische Aufwand darin, keinen falschen Alarm auszulösen. Kamerafotos enthalten eingebettete EXIF-Miniaturansichten, die ihre eigene JPEG-Signatur tragen. Office-Dokumente betten Bilder in ihre Containerstruktur ein. „ Media “-Dateien enthalten zufällig Byte-Sequenzen, die wie Komprimierungs-Header aussehen. Die Erkennungslogik schließt Bytes aus, die bereits durch eine legitime Struktur abgedeckt sind, und diese Absicherung wird kontinuierlich Format für Format erweitert. Ein Detektor, der jedes Kamerafoto markiert, wird deaktiviert – und ein deaktivierter Detektor schützt niemanden.
An echten Polyglotten getestet
Wir haben echte polyglotte Beispiele durch eine Live-Bereitstellung von „ MetaDefender Core™“ mit der „File Structure Validation“-Engine laufen lassen. Jedes einzelne wurde erkannt, und jede Fehlstelle wurde genau auf ihren Byte-Offset lokalisiert:
Beispiel | Gefundene Flächen (Versatz) | Ergebnis |
PDF, in dem ein Word-Dokument versteckt ist (PDF+JAR+DOCX in einer Datei) | PDF @ 0 · ZIP @ 34.016 | Gesichter entfernt; die versteckte DOCX-Datei wurde mithilfe der Deep CDR™-Technologie bereinigt |
GIF, das ein Archiv und ein zweites Bild verbirgt | GIF89a @ 0 · ZIP @ 25.214 · TIFF @ 154.270 | Erkannt |
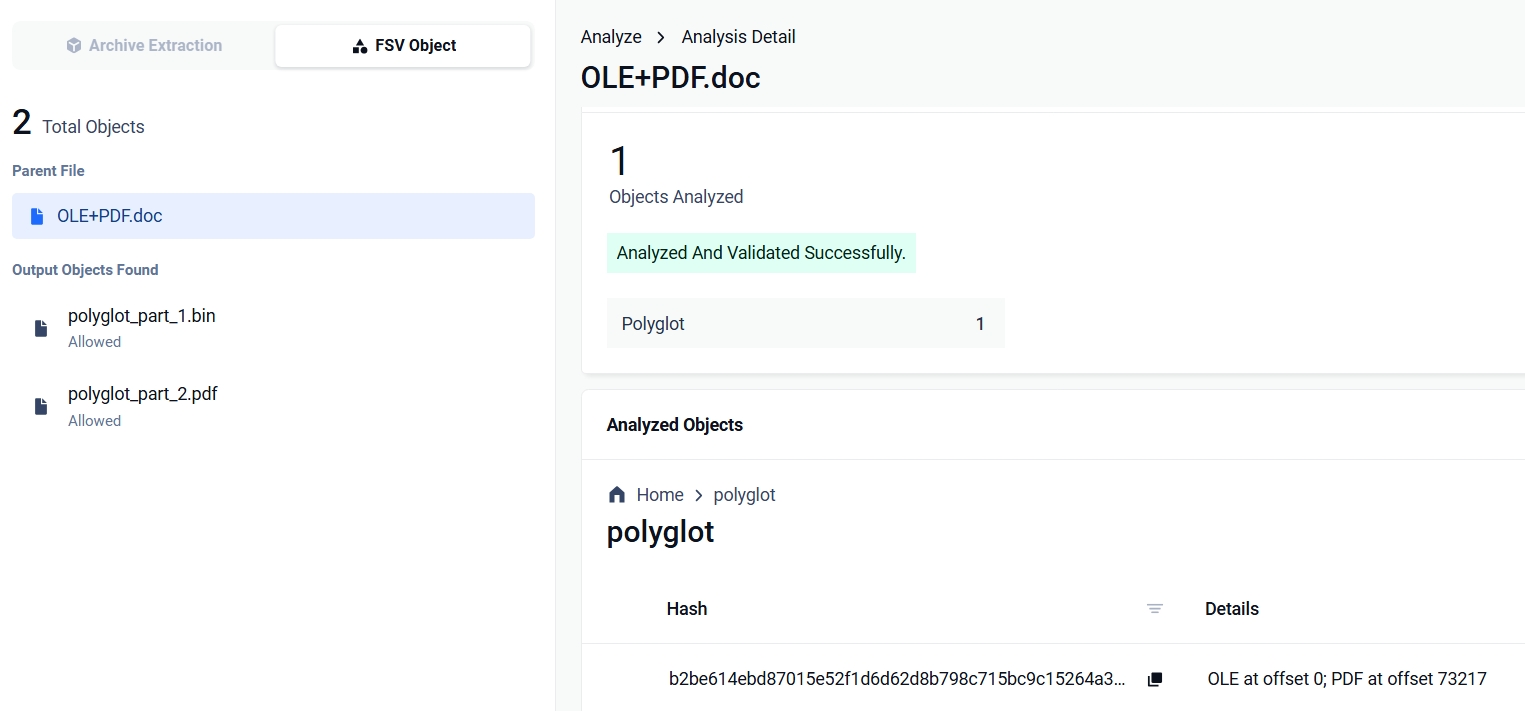
Office-Dokument, in dem eine PDF-Datei versteckt ist | OLE @ 0 · PDF @ 73.217 | Erkannt |
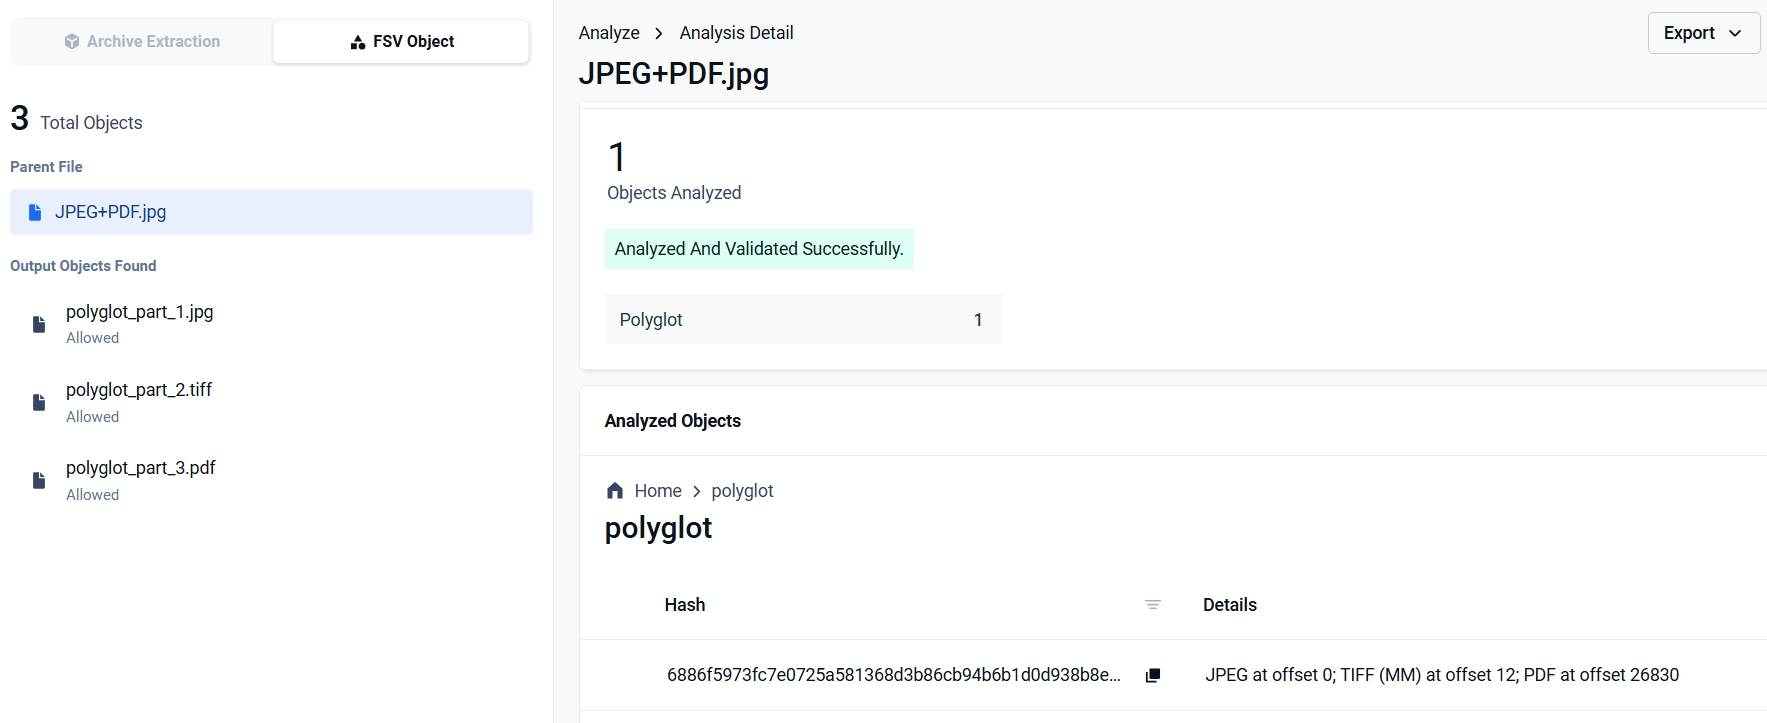
JPEG, in dem ein PDF versteckt ist | Drei Gesichter, PDF im Anhang @ 26.830 | Erkannt |
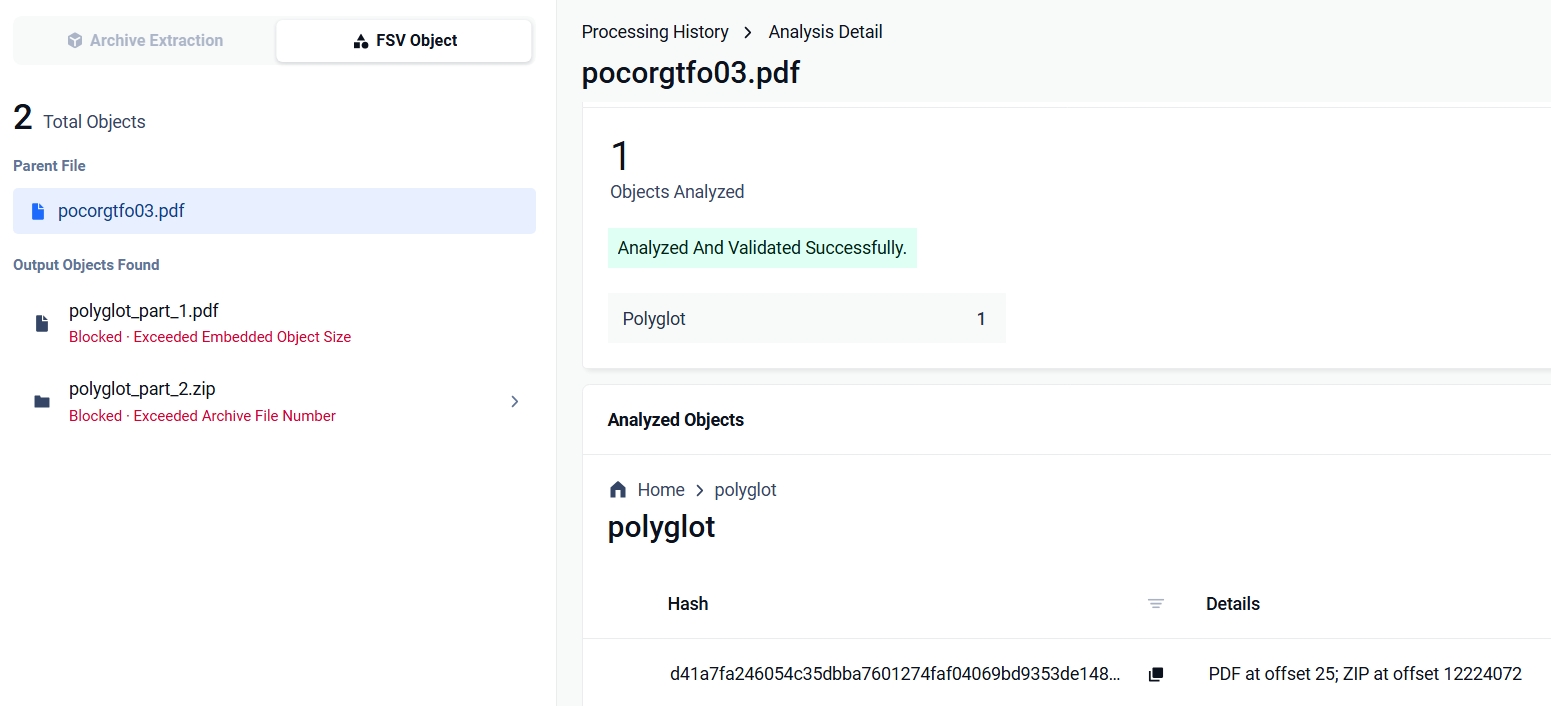
„PoC‖GTFO“, Ausgabe 3, das Zine zur Sicherheitsforschung, als mehrsprachiges PDF+ZIP-Paket, 26 MB | PDF @ 25 · ZIP @ 12.224.072 | Erkannt: Das zweite Gesicht wurde bei einem vollständigen Scan in einer Tiefe von 12 MB gefunden. |
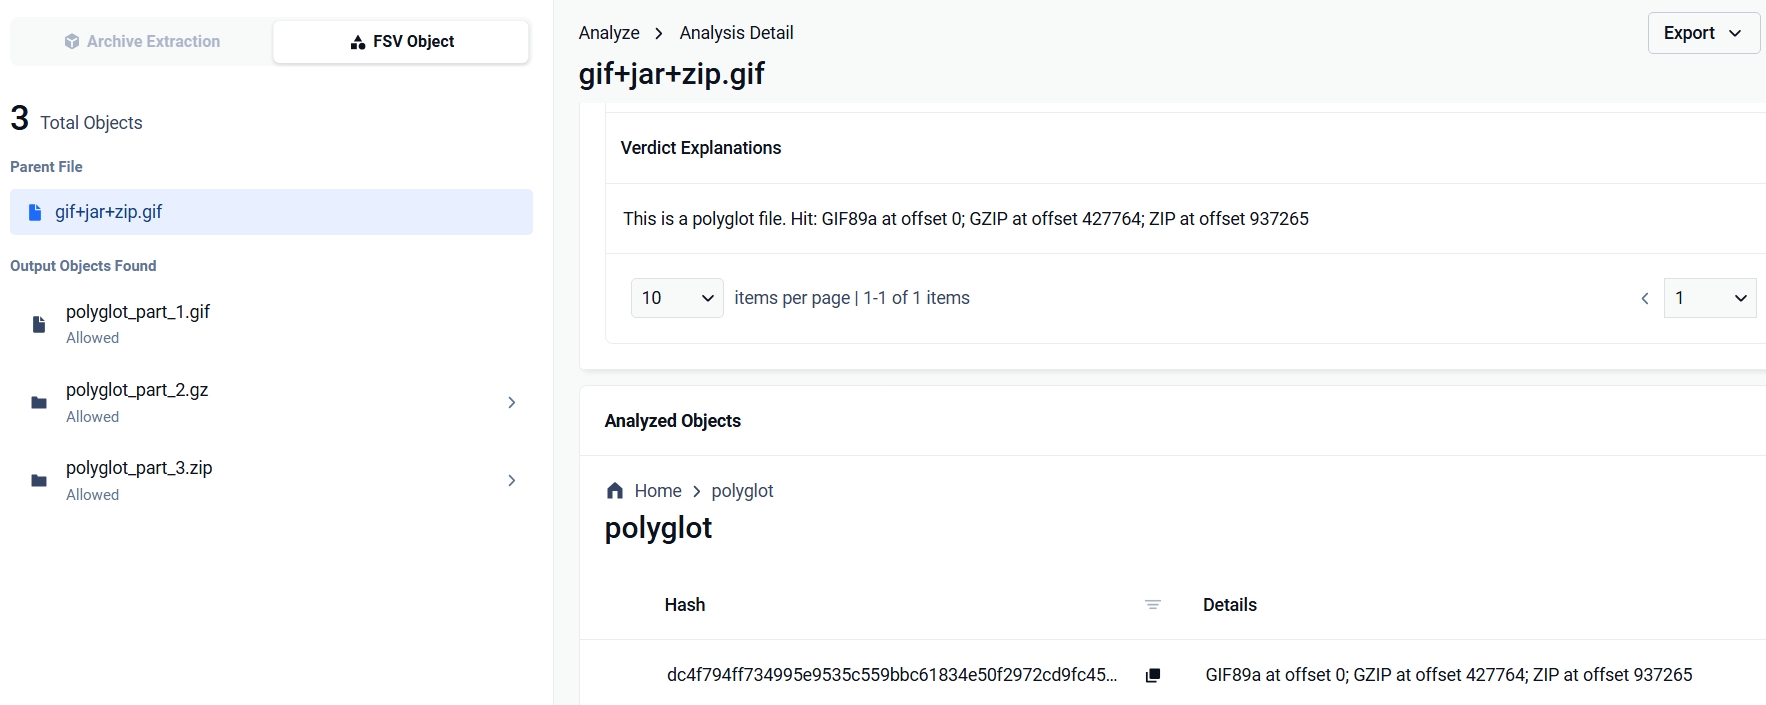
GIF, das einen GZIP-Stream und ein Java-Archiv enthält | GIF89a @ 0 · GZIP @ 427.764 · ZIP @ 937.265 | Gesperrt |
PDF-Datei, in die ein JPG- und ein PNG-Bild eingebettet sind, mit einer angehängten ZIP- und einer TIFF-Datei | PDF @ 0 · ZIP @ 204.849 · TIFF @ 257.395 | Blockiert; die eingebetteten Bilder werden zu Recht nicht gemeldet |
In der letzten Zeile kommt die Ausschlussregel zum Tragen: Das Ergebnis nennt die angehängten ZIP- und TIFF-Dateien und ignoriert die Bilder im PDF. Der Container-Resolver hat diese als eigenen Inhalt des PDFs gewertet. Das JSON-Ergebnis von „ MetaDefender Core™“ für diese Datei (gekürzt):
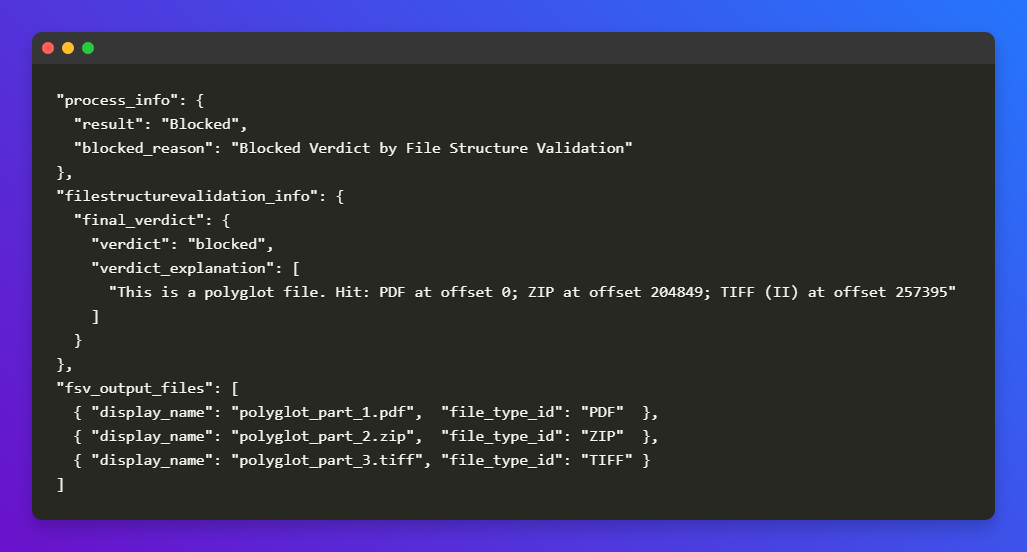
Die Liste „fsv_output_files“ entspricht der oben beschriebenen Zerlegung in Echtzeit: Die drei Flächen werden herausgeschnitten und als eigenständige Objekte an den Workflow zurückgegeben.
Hier sind die Screenshots der einzelnen Beispielergebnisse in „ MetaDefender Core™“:
Geltungsbereich und Konfiguration
Die aktuelle Abdeckung umfasst die Formate, die Angreifer tatsächlich kombinieren: PDF, ZIP, OLE-Zusammensetzungsdateien, PNG, GIF, JPEG, TIFF, RAR, GZIP und 7z.
Die strukturelle Auflösung am Containerende gilt für die Containerformate. Die Funktion wird nach dem „Configuration-First“-Prinzip bereitgestellt: Erkennung, Blockierung und vollständige Dateiprüfung sind jeweils über Richtlinien schaltbar, sodass Betreiber bei jeder Bereitstellung zwischen Transparenz und Durchsetzung wählen können.
Die Quintessenz
Eine Datei mit zwei gültigen Facets überlistet jede Pipeline, die ihr nur einen Typ zuweist, und die Erkennung eines einzigen Typs ist die Grundlage der meisten Scan-Stacks. Die strukturelle Polyglot-Erkennung schließt diese Lücke, indem sie jedes Facet identifiziert und nachweist, dass jedes einzelne analysierbar ist. Die Richtlinie kann die Datei dann blockieren, bevor eine Anwendung den falschen Interpreter auswählt.
Die Erkennung aller gängigen Angriffsformate wird bereits heute unterstützt. Die Auflösung am Ende des Containers für die verbleibenden Archivformate ist in der Roadmap vorgesehen.
Erfahren Sie, wie die Dateistrukturprüfung die Dateiformate verarbeitet, die in Ihrer Umgebung zirkulieren.