Über MetaDefender Cloud
MetaDefender Cloud ist die cloudbasierte Plattform OPSWATfür die Prävention komplexer Bedrohungen und die Analyse von Malware. Unsere einzigartige Kombination aus Deep CDR™-Technologie und Multiscanning über 20 der besten AV-Engines schützt Unternehmen vor Zero-Day-Angriffen und immer raffinierterer Malware. Die SandboxCloud MetaDefender Cloudin Kombination mit Echtzeit-Hash-, IP- und Domain-Analysen unter Verwendung der erstklassigen Bedrohungsdatenbank OPSWATunterstützt Malware-Forscher und vermittelt ein tiefgreifendes Verständnis bestehender und potenzieller Bedrohungen.
Die MetaDefender Cloud unterstützt derzeit mehr als 5 Millionen Scan-Anfragen pro Tag von unseren Kunden und bietet ihnen dennoch eine durchschnittliche Scan-Zeit von 0,4 Sekunden.
Warum haben wir MetaDefender as a Service (MDaaS) entwickelt?
Die Anforderungen des Marktes erfüllen und unsere Kunden besser unterstützen
Wir wollten sicherstellen, dass MetaDefender Cloud skaliert werden kann, um den sich ändernden Anforderungen und dem wachsenden Bedarf an fortschrittlichen Anwendungssicherheitsdiensten und der zunehmenden Komplexität von DevOps Security gerecht zu werden, da immer mehr Anwendungen in die Cloud verlagert werden. Mit der Zunahme des Dateiverkehrs war es eine Notwendigkeit, dass MetaDefender Cloud seine Leistung beibehält und verbessert, um eine reibungslose Benutzererfahrung für unsere Endkunden zu gewährleisten.
Verbesserung der Überwachung und prädiktiven Skalierung
Wir haben beschlossen, unsere lokale Architektur auf Cloud-natives Kubernetes zu migrieren, das auf Microservices mit Infrastructure-as-Code basiert, um eine nahtlose und konsistente Erfahrung im Vergleich zum aktuellen Bereitstellungs- und Überwachungsmodell bieten zu können.
MetaDefender Architektur als Dienstleistung
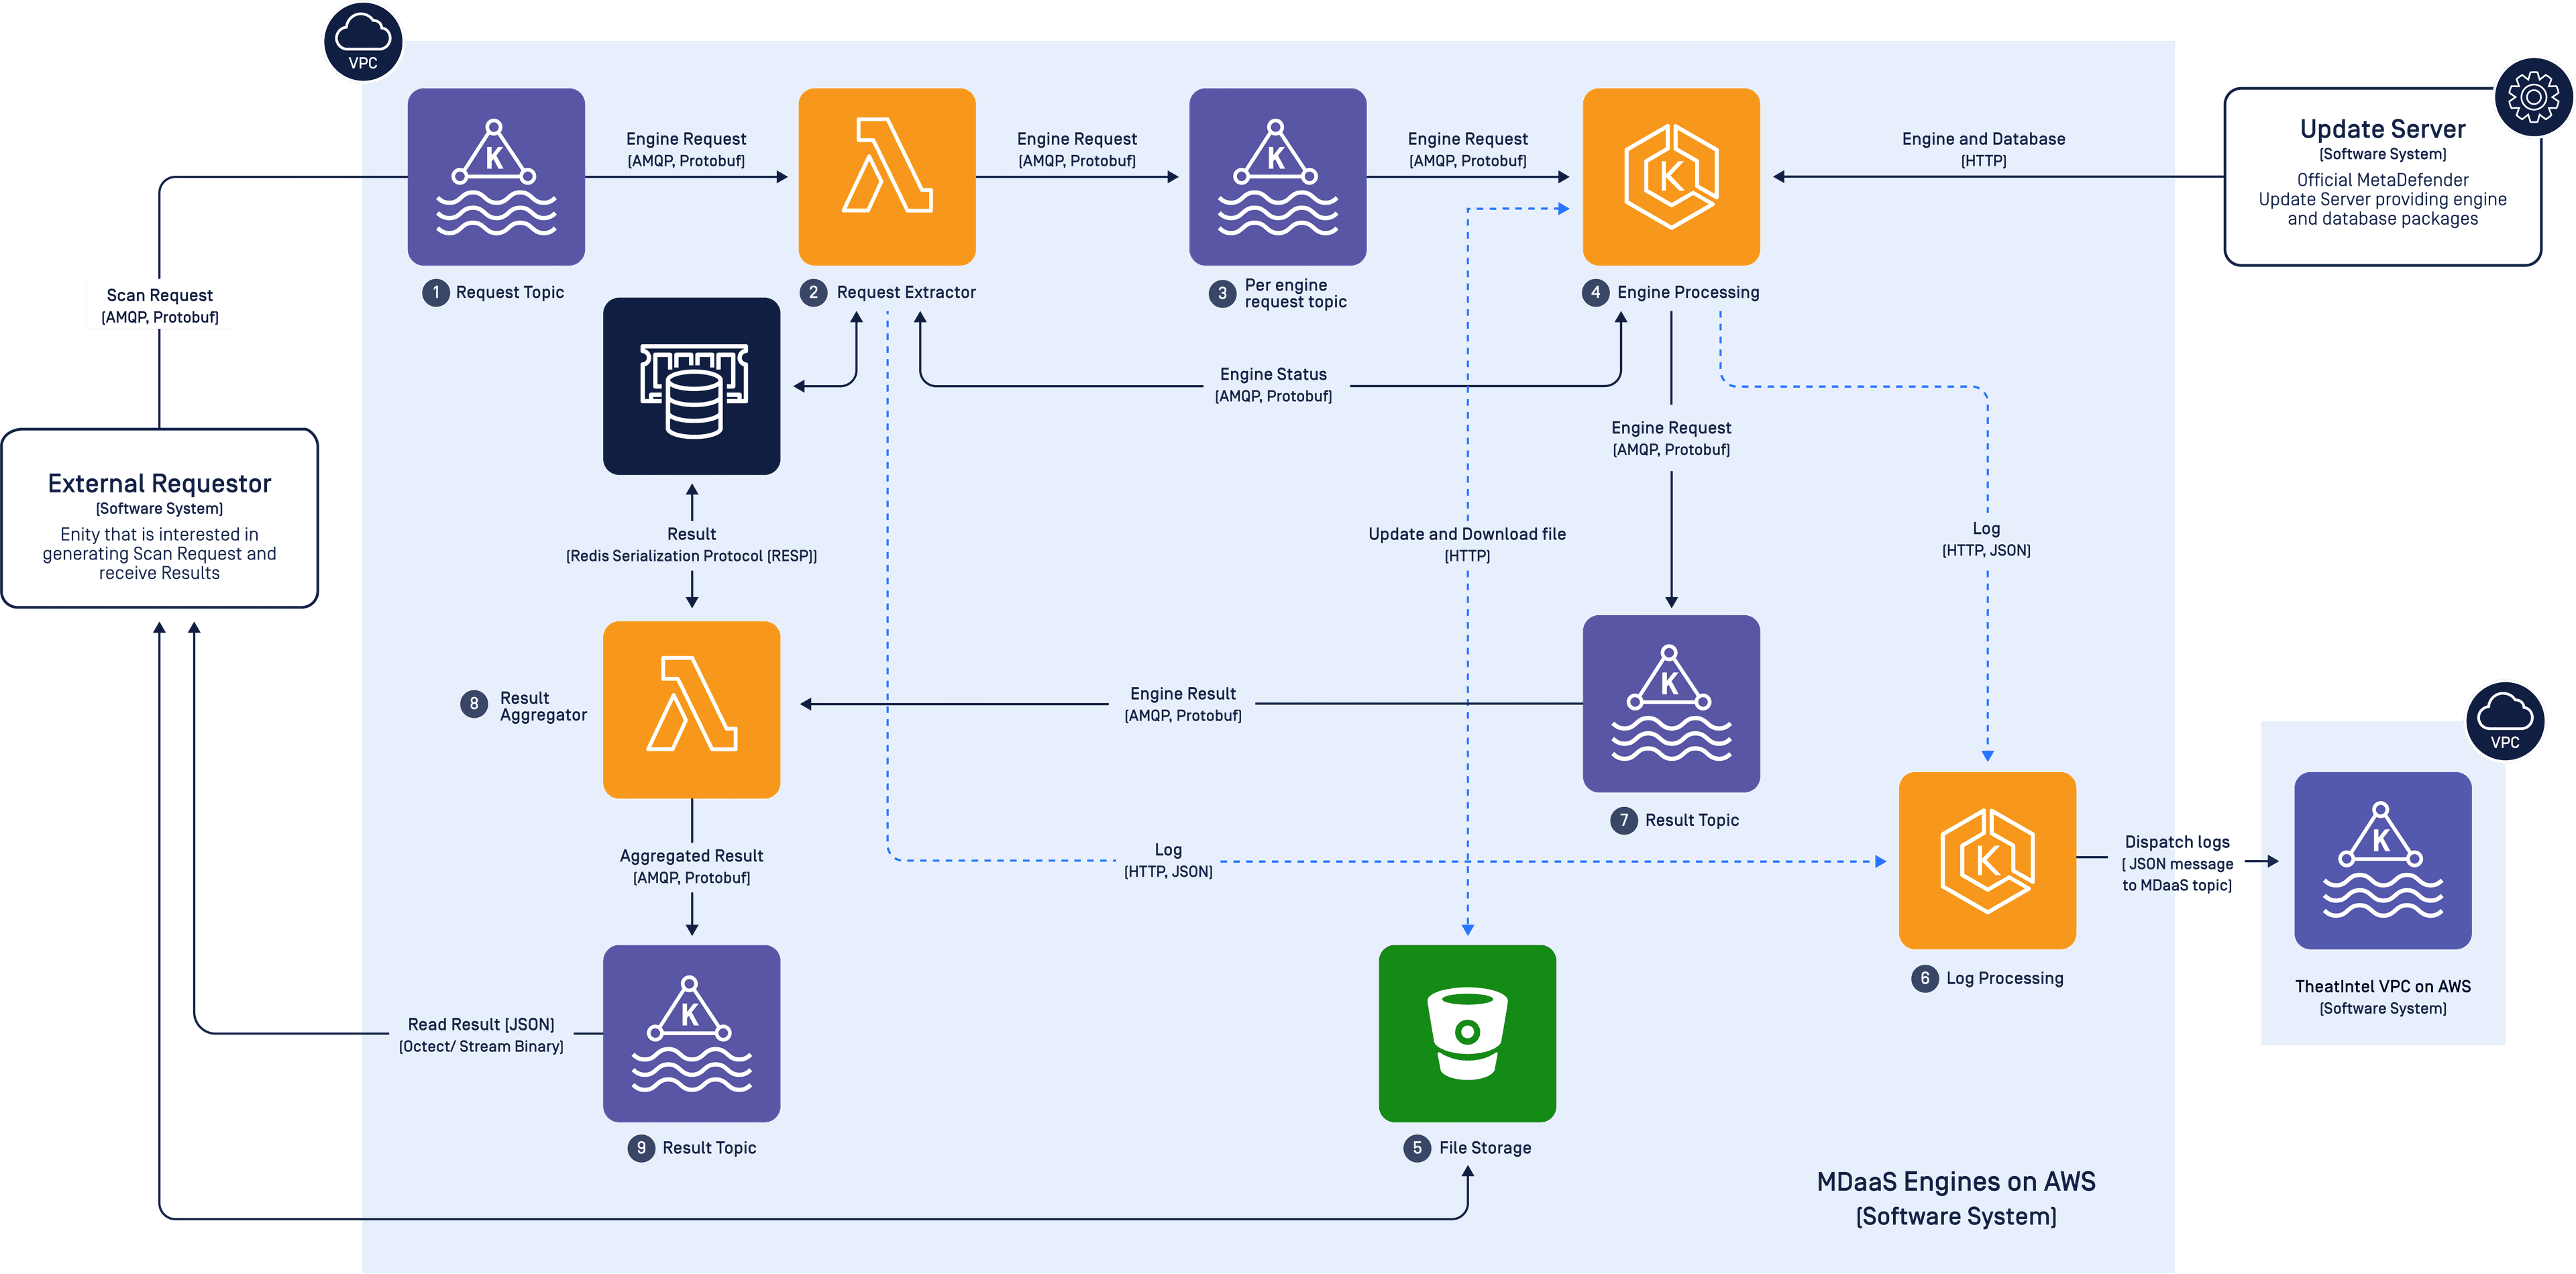
Bei der Migration zu MDaaS wurden unsere Multiscanning Dienste von der Windows-basierten AMI auf einen Kubernetes-basierten Cluster verlagert. Die Administratoren können nun die Skalierbarkeit pro Engine konfigurieren. Da die Leistung der Engines unterschiedlich ist, kann die langsamere(n) Engine(s) hochskaliert werden, um schnelle Scanzeiten zu erhalten.
Der Ablauf der Dateiverarbeitung sieht nun wie folgt aus:
1. Eine Nachricht eines externen Anfragenden wird an ein Kafka-Topic namens „request“ (1) gesendet, das Anweisungen zur Anfrage enthält, wie beispielsweise das Scannen einer Datei mit AV1, AV2 usw., deren Bereinigung mit der Deep CDR™-Technologie und die Analyse der Datei mit Sandbox usw.
2. Anschließend unterteilt ein Lambda-Extraktor (2), der die Nachrichten abonniert hat, die Anfrage in verschiedene Befehle und leitet diese an ein anderes Kafka-Thema (3) weiter, wo sie anschließend klassifiziert und der bzw. den entsprechenden Engine(s) zugewiesen werden. (4)
3. Die Engine-Verarbeitung (4) ist das Herzstück des Systems. Sie umfasst mehrere Engine-Container, läuft auf dem Amazon Elastic Kubernetes Service (EKS) und lässt sich je nach Arbeitslast nach oben oder unten skalieren. Jede Engine bearbeitet eine bestimmte Anfrage, wodurch die Verarbeitungsleistung gesteigert wird.
4. Im Rahmen dieses Vorgangs wird außerdem ein S3-Bucket (5) zur Speicherung der Eingabe- und Ausgabedateien verwendet.
5. Gleichzeitig empfängt ein verfügbares Protokollverarbeitungsmodul (6) das Protokoll von den Engines und leitet es an ein Protokollanalysesystem weiter.
6. Nach der Dateiverarbeitung wird das von jeder Engine ermittelte Ergebnis an das Kafka-Thema „results“ zurückgesendet (7)
7. Anschließend fasst ein Microservices-Aggregator unter Verwendung von AWS Lambda (8) die Ergebnisse in einem Bericht zusammen und sendet diesen an ein Kafka-Thema (9), von wo aus er an den Aufrufer zurückgeleitet wird.
Technische Herausforderungen und Lösungen
Vorhersage des Motorverhaltens und Umgang mit Anomalien
Die herkömmliche MD Core AMI Bereitstellung ermöglicht es den Engines, auf einem leistungsstarken Computer zu laufen, wo sie die Ressourcen (CPU, RAM, Festplatte, Netzwerk usw.) gemeinsam nutzen können. Bei der Microservices-Architektur hingegen läuft jede Engine einzeln in einem weniger leistungsfähigen Container. Daher war es für uns in diesem Fall schwierig, die Ressourcenanforderungen des Systems zu definieren.
Um dieses Problem zu lösen, verwendeten wir historische Daten aus dem alten System, um eine Basislinie für jede Engine festzulegen, und fügten Datadog-Überwachung hinzu. Wir überwachten das Verhalten der Engines und nahmen eine Feinabstimmung der Infrastruktur vor, bis das Produkt eine hervorragende Leistung erzielte.
Ein ausgewogenes Verhältnis zwischen Leistung und Hosting-Kosten
Mit der neuen Architektur kann MetaDefender Cloud leicht skaliert werden, um sich den grenzenlosen Bedürfnissen unserer Kunden anzupassen und eine optimale Leistung zu erzielen. Allerdings bedeutet dies auch, dass die Wartungskosten proportional ansteigen können. Ohne Ausgabenkontrollen oder Governance-Modelle konnte die Skalierung unkontrollierbar sein und zu höheren Rechnungen für Cloud-Dienste führen, die weit über das ursprünglich zugewiesene Budget hinausgingen.
Daher wurden häufige Architekturüberprüfungen mit den Beteiligten durchgeführt, um konsistente Erfahrungen mit stabilen und ausgewogenen Kosten zu gewährleisten.
Simulation der Umwelt
Die Simulation einer Produktionslast in einer nicht produktiven Umgebung ohne echte Daten ist eine Herausforderung. Um dies zu bewältigen, haben wir parallele Workflows eingerichtet, so dass echte Daten sowohl die alte als auch die neue Architektur durchlaufen, so dass wir die wichtigsten Metriken beider nebeneinander bewerten konnten. Durch diesen direkten Vergleich konnten wir schnell und effektiv feststellen, in welchen Bereichen die neue Architektur der alten überlegen war und wo die neue Architektur verbessert werden musste.
Überwachung, Berichterstattung und Kontrolle
Überwachung der Cloud-Infrastruktur in Echtzeit
MetaDefender Cloud legt großen Wert darauf, ein robustes Monitoring in seine Systeme zu integrieren, um einen klaren Überblick über den Systemzustand zu erhalten. Für einen Dienst wie MDaaS, der mehr als 44 Anfragen pro Sekunde (RPS) bei einer Fehlerrate von 0,6 % verarbeiten kann, auf mehrere vorgelagerte Systeme und Partner-Ökosysteme als Datenverkehrsquelle angewiesen ist und gleichzeitig einen hohen Datenverkehr für verschiedene interne und externe nachgelagerte Systeme erzeugt, ist es wichtig, eine starke Kombination aus Metriken, Warnmeldungen und Protokollierung zu haben.
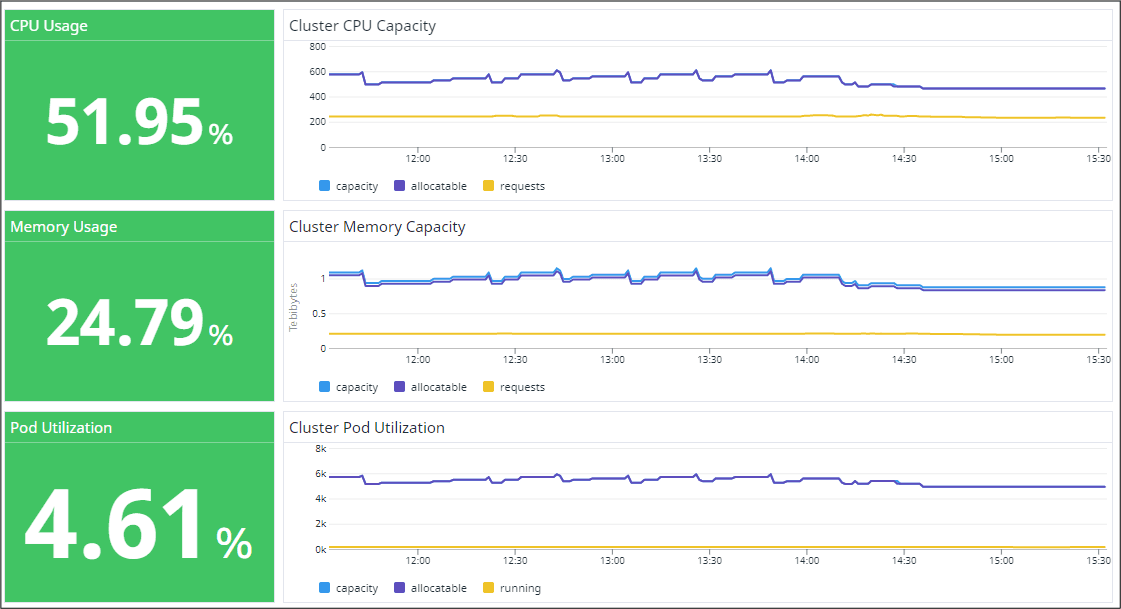
Warnungen bei hohem abnormalem Datenverkehr durch Umgebungen in Datadog
Zusätzlich zu den standardmäßigen Systemzustandsmetriken wie CPU, Arbeitsspeicher und Leistung haben wir mehrere "Edge-of-the-Service"-Metriken hinzugefügt, z. B. Wachstum in der Warteschlange, Antwortzeit des Dienstes, Status-Cake und Protokollierung, um jegliche Abweichungen von vor- oder nachgelagerten Systemen zu erfassen. Darüber hinaus haben wir Trendanalysen für wichtige Metriken hinzugefügt, um längerfristige Verschlechterungen zu erkennen. Wir instrumentierten MDaaS mit einer Echtzeit-Stream-Processing-Anwendung namens Datadog (mehr darüber erfahren Sie hier). Damit konnten wir Ereignisse in Echtzeit über die Leitung mit containerspezifischer Granularität verfolgen, was die Fehlersuche erleichterte. Schließlich fanden wir es nützlich, dienstspezifische Warnmeldungen zu haben, um die Ursachen von Problemen schneller zu identifizieren.
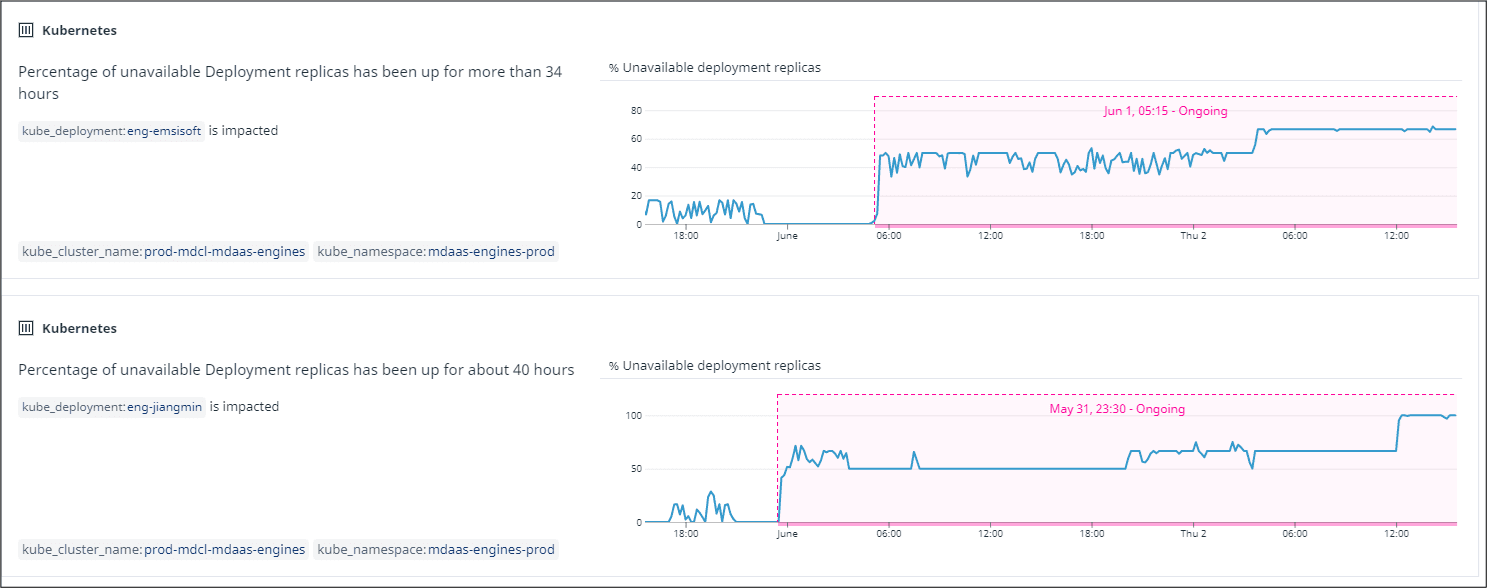
Erstellung von Vorfällen zu Ausnahmen, die die Aufmerksamkeit von Site Reliability Engineers in Datadog erfordern
SaaS-Monitoring mit der Datadog-Plattform ermöglicht Teams eine schnellere und einfachere Einführung und macht die laufende Wartung, Kapazitätsskalierung, Aktualisierung oder Verwaltung von Tools überflüssig. Diese Vorteile bedeuten, dass die Teams mehr Zeit haben, um am Kernprodukt zu arbeiten und nicht selbst eine Überwachungslösung erstellen müssen.
Ergebnisse
• Durch die Umstellung auf MDaaS ist der Engine-Mikroservice nun flexibler und trägt so dazu bei, die Anforderungen der FedRAMP-Baseline für Sicherheitskontrollen der Stufe „Moderate“ zu erfüllen.
• Die Überwachung der Anwendungsleistung wurde nun um Echtzeit-Benachrichtigungen und Dashboards erweitert. Die neue Microservices-Architektur ermöglicht es Administratoren, die Anwendung und jede einzelne Komponente einfach und effektiv zu überwachen. Außerdem erleichtert sie die Bereitstellung und Skalierbarkeit.
• Da die Infrastruktur als Code definiert ist, können Nutzer Konfigurationen problemlos bearbeiten und verbreiten, während gleichzeitig der gewünschte Zustand der Infrastruktur gewährleistet bleibt. Das bedeutet, dass Sie reproduzierbare Infrastrukturkonfigurationen erstellen können.
Erfahren Sie mehr über MetaDefender Cloud oder kontaktieren Sie uns für weitere Informationen.
